Web Unlocker API 教程:Python 和 Node.js,阻止与未阻止
用于 Web Unlocker API 的 Python 和 Node.js 代码:针对阻止普通客户端的网站和不阻止的网站进行相同请求,如何读取 Unlocker 报告,以及仅在检测到阻止时才支付 Unlocker 的助手。
一个 Web Unlocker API 从浏览器 TLS 指纹下的住宅 IP 重放 HTTP 请求,在站点回答挑战时重试新 IP 并切换到真实浏览器。此 Web Unlocker API 教程展示了它在 Python 和 Node.js 中的应用,针对一个阻止普通客户端的网站和一个不阻止的网站。
以下引用的每个结果均在 2026 年 9 月 29 日测量:使用普通 curl 从法兰克福的数据中心服务器获取相同的 URL,通过具有美国出口的住宅代理使用普通 curl,以及通过 QuantumProxies.io Web Unlocker 使用美国出口。对于不需要 Unlocker 的网站,我们会说明,因为最便宜的请求是不需要它的请求。
- 两种进入方式:一个用于已经支持代理协议的代码的正向代理,位于
unlock.quantumproxies.io:9000,或使用您的 API 密钥的POST /api/v1/scraper/unlock,用于其他所有情况。 - 您得到的内容:源站的状态、头和主体,加上
x-qp-*头,说明尝试了多少次,是否运行了浏览器,以及如果有的话,是什么类型的墙阻止了它。 - 当您不需要它时:Wikipedia、GitHub、docs.python.org、Hacker News 和 books.toscrape.com 在我们的测试中都回答了普通请求。先尝试普通请求,只有在检测到阻止时才升级。
开始前您需要准备的内容
- 一个具有 Web Unlocker 带宽的 QuantumProxies.io 账户。Unlocker 从预付 GB 余额中扣费,住宅层和移动层(4G/5G 运营商出口)分开。
- 对于正向代理:在仪表板的 Web Unlocker 页面上创建的代理子用户。看起来像
unlock-XXXXXXXX,有自己的密码。这不是您的 API 密钥。 - 对于 REST 端点:从仪表板获取的 API 密钥,以
Authorization: Bearer形式发送。 - Python 3.10 或更新版本,带有
requests,Node.js 部分需要 Node 18 或更新版本,带有undici包。
将这两个秘密保存在环境变量中。示例读取 QP_UNLOCK_USER、QP_UNLOCK_PASSWORD 和 QP_API_KEY。如果代理密码包含 @ 或 : 等字符,请在将其放入代理 URL 之前使用 urllib.parse.quote 进行 URL 编码。
步骤 1:使用普通 Python requests 查看阻止
从失败开始,这样您就知道要修复什么。目标是 Indeed 的职位搜索。从我们的法兰克福数据中心服务器,它回答了 403,页面标题为“Security Check - Indeed.com”。通过普通住宅代理,它仍然回答 403,这次页面要求客户端“启用 JavaScript 和 cookies 以继续”。一个干净的家庭 IP 不够。
import re
import requests

URL = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX"
HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/150.0.0.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}


def title_of(html: str) -> str:
    m = re.search(r"<title[^>]*>(.*?)</title>", html, re.I | re.S)
    return m.group(1).strip() if m else ""


r = requests.get(URL, headers=HEADERS, timeout=30)
print(r.status_code, "|", title_of(r.text))
# Our datacenter run on 29 Sep 2026 saw: 403 | Security Check - Indeed.com
我们的测量使用了带有 Chrome User-Agent 的 curl,而不是 requests,没有理由期望 requests 表现更好。User-Agent 字符串是一个头。反机器人层还读取 TLS 握手和 HTTP/2 设置,无论您设置什么 User-Agent,它们仍然显示 Python。这就是为什么在 Python requests 中交换头很少能让您通过机器人检测;握手部分在我们的指南中涵盖了TLS 指纹识别以及为什么干净的 IP 仍然会被阻止。403 意味着服务器理解请求并拒绝了它(RFC 9110,第 15.5.4 节)。这并不意味着您的 URL 或参数有误。
步骤 2:通过正向代理进行相同调用
正向代理是对现有代码的最小更改:将其作为代理传递,其他不动。目标在用户名中传递。-country-us 选择出口国家,-tier-mobile 切换到移动出口,-profile-firefox(或 chrome、safari、safariios、edge、brave、mobile)固定一个 TLS 指纹,而不是让重试轮换它。
import os
import requests
import urllib3

urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

user = os.environ["QP_UNLOCK_USER"] + "-country-us"   # e.g. unlock-XXXXXXXX-country-us
password = os.environ["QP_UNLOCK_PASSWORD"]
PROXY = f"http://{user}:{password}@unlock.quantumproxies.io:9000"

r = requests.get(
    URL,
    headers=HEADERS,
    proxies={"http": PROXY, "https": PROXY},
    verify=False,   # or verify="qp-unlocker-ca.pem", see below
    timeout=120,
)
print(r.status_code, "|", title_of(r.text))
print("attempts:", r.headers.get("x-qp-unlocker-attempts"),
      "rendered:", r.headers.get("x-qp-unlocker-rendered"))
在 9 月 29 日,这在第一次 TLS 尝试中返回了标题为“Now Hiring: 2,000 Data Engineer Jobs in Austin, TX | Indeed”的真实结果页面,耗时 2.6 秒,没有启动浏览器。
为什么 verify=False?为了重写 HTTPS 请求,Unlocker 必须终止客户端的 TLS 并为目标主机提供自己的证书。您有两个干净的选项。仅为此会话关闭验证,如上所示,这就是 curl -k 所做的。或者下载 Unlocker CA 一次并显式信任它,这样验证保持开启:
curl -H "Authorization: Bearer $QP_API_KEY" \
  -o qp-unlocker-ca.pem https://app.quantumproxies.io/api/v1/scraper/unlock/ca
然后传递 verify="qp-unlocker-ca.pem" 而不是 False。requests 高级用法文档涵盖了 proxies 参数和自定义 CA 包。如果您两者都不想要,下面的 REST 端点根本不需要证书。
步骤 3:REST 端点,无代理协议
REST 端点在正常 HTTPS 调用后运行相同的引擎。您描述您将要进行的请求(url、method、headers、body),并以 JSON 格式返回源站的答案。唯一必填字段是 url。
import os
import requests

API_KEY = os.environ["QP_API_KEY"]

resp = requests.post(
    "https://app.quantumproxies.io/api/v1/scraper/unlock",
    headers={"Authorization": f"Bearer {API_KEY}"},
    json={
        "url": URL,
        "country": "us",
        # "tier": "mobile",        # mobile exits, billed on the mobile balance
        # "failOnBlock": True,     # HTTP 502 instead of 200 when every tier was blocked
    },
    timeout=130,
)
resp.raise_for_status()           # 402 = no unlocker GB left, 400 = bad input
data = resp.json()["payload"]

print(data["status"], "blocked:", data["blocked"])
print("attempts:", data["attempts"], "rendered:", data["rendered"],
      "escalated:", data["escalated"], "clearance:", data.get("clearance"))
if data["blocked"]:
    print("block class:", data.get("blockClass"), "vendor:", data.get("vendor"))
html = data.get("body") or ""     # text form; bodyBase64 is always present too
响应封装为 { type, message, payload }。在 payload 中,您会得到 status(源站的状态码)、headers、body 和 bodyBase64、finalUrl、指纹 profile、attempts、rendered、escalated、blocked,以及当某事阻止请求时的 blockClass 和 vendor。一个 usage 对象报告通话中扣除的字节数。
需要设计的一个行为:默认情况下,在每次尝试后仍被阻止的请求仍然从 API 返回为 HTTP 200,blocked: true 和 body 中的阻止页面以供检查。它被标记,而不是伪装。如果您的管道将任何 200 视为成功,请设置 failOnBlock: true,您将获得一个 502,携带相同的诊断信息。其他值得了解的字段:POST 的 method 和 body,render: "html" 以在浏览器中启动,waitForSelector 和 returnCookies。
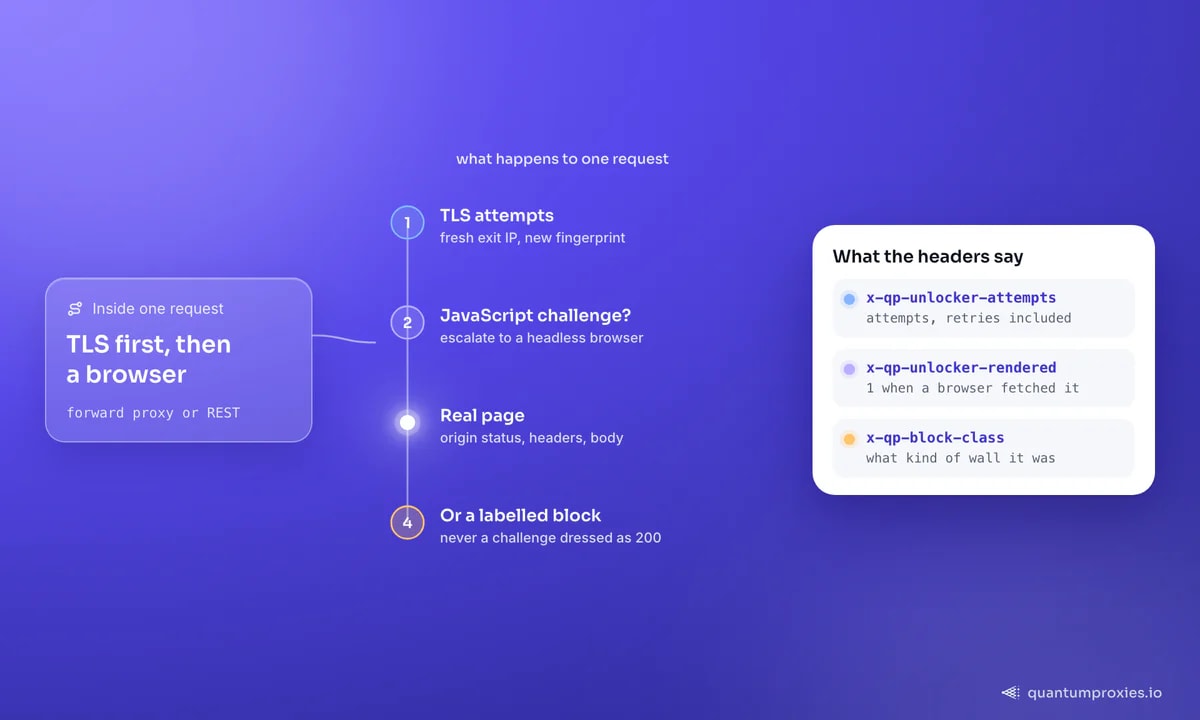
步骤 4:读取 x-qp 头并处理报告的阻止
通过正向代理,Unlocker 在响应本身上报告。这些是每次调用中值得记录的头:
| Header | 它告诉您什么 |
|---|---|
| x-qp-unlocker-attempts | 请求所需的尝试次数,包括重试 |
| x-qp-unlocker-rendered / x-qp-unlocker-escalated | 当无头浏览器获取页面时设置为 1 / 当请求从 TLS 层升级时 |
| x-qp-unlocker-profile | 返回的尝试使用了哪个浏览器指纹 |
| x-qp-clearance | 此调用中浏览器清除缓存的情况:minted、hit 或 miss |
| x-qp-session / x-qp-country | 实际使用的退出会话和国家 |
| x-qp-unlocker-blocked | 仅在每次尝试后页面仍被阻止时出现 |
| x-qp-block-class / x-qp-vendor | 是什么类型的墙,以及识别出的反机器人供应商 |
仍然被阻止的页面永远不会作为静默的 200 到达。如果源站以其自己的错误(403、429、503)拒绝,该状态将不变地传递,并设置 x-qp-unlocker-blocked。如果源站以 2xx 提供挑战页面,代理将其转换为 502,并将源站的代码放入 x-qp-origin-status。因此,一个检查涵盖了两者:
class Blocked(Exception):
    pass


s = requests.Session()
s.proxies = {"http": PROXY, "https": PROXY}
s.verify = False  # or "qp-unlocker-ca.pem"

NEXT_STEP = {
    "js_challenge":  "a browser could not clear it; retry later in a pinned session",
    "captcha":       "interactive captcha; decide in your own code",
    "access_denied": "the site denied access; retry with a fresh session or test tier-mobile",
    "rate_limited":  "the site is rate limiting; slow down and retry later",
    "fingerprint":   "the client fingerprint was refused; retry with another profile",
    "geo":           "the content depends on location; set the country explicitly",
    "timeout":       "the target was too slow; raise x-qp-timeout or retry",
}


def unlock_get(url: str, session_id: str | None = None) -> requests.Response:
    headers = {"x-qp-session": session_id} if session_id else {}
    r = s.get(url, headers=headers, timeout=120)
    if "x-qp-unlocker-blocked" in r.headers:
        cls = r.headers.get("x-qp-block-class", "unknown")
        raise Blocked(
            f"{url}: HTTP {r.status_code}, class={cls}, "
            f"vendor={r.headers.get('x-qp-vendor')}, next: {NEXT_STEP.get(cls, 'inspect the body')}"
        )
    return r
步骤 5:Node.js 版本(JavaScript 中的 Web Unlocker API)
在 Node 中,fetch 需要一个 dispatcher。使用 undici 中的 ProxyAgent 作为正向代理,并从同一包中导入 fetch,以便两个版本匹配。ProxyAgent 文档列出了这里使用的选项:token 用于 Proxy-Authorization 值,requestTls 用于目标的 TLS 设置。
// unlock.mjs  (npm i undici)
import { readFileSync } from "node:fs";
import { fetch, ProxyAgent } from "undici";

const user = process.env.QP_UNLOCK_USER + "-country-us";
const pass = process.env.QP_UNLOCK_PASSWORD;

const dispatcher = new ProxyAgent({
  uri: "http://unlock.quantumproxies.io:9000",
  token: "Basic " + Buffer.from(user + ":" + pass).toString("base64"),
  requestTls: { rejectUnauthorized: false },
  // verified instead: requestTls: { ca: readFileSync("qp-unlocker-ca.pem") },
});

const url = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX";
const res = await fetch(url, { dispatcher, headers: { "x-qp-session": "indeed-001" } });

if (res.headers.get("x-qp-unlocker-blocked")) {
  console.error("blocked:", res.status, res.headers.get("x-qp-block-class"), res.headers.get("x-qp-vendor"));
} else {
  const html = await res.text();
  console.log(res.status, res.headers.get("x-qp-unlocker-attempts"), html.length);
}
REST 端点不需要超过 Node 18+ 内置的 fetch:
const resp = await fetch("https://app.quantumproxies.io/api/v1/scraper/unlock", {
  method: "POST",
  headers: {
    Authorization: "Bearer " + process.env.QP_API_KEY,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({ url: "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX", country: "us" }),
});
const { payload } = await resp.json();
console.log(payload.status, payload.blocked, payload.blockClass ?? "-", payload.attempts);
在 axios 上,代理后面的 HTTPS 目标的常用模式是将 https-proxy-agent 的代理作为 httpsAgent 传递,并设置 proxy: false,或者调用上面的 REST 端点并完全跳过代理协议。
步骤 6:当您不需要 Unlocker 时
Unlocker 按每个移动的字节收费,包括重试和浏览器页面加载。发送它可以通过普通请求正常获取的页面会白白消耗余额。在我们的运行中,这些页面没有任何帮助就正常返回:
| 网站 | 普通,数据中心服务器 | 普通,住宅代理 | Web Unlocker |
|---|---|---|---|
| docs.python.org(urllib.request 页面) | 200 | 200 | 200,1.6 秒 |
| books.toscrape.com | 200 | 200 | 200,1.9 秒 |
| news.ycombinator.com | 200 | 200 | 200,4.1 秒 |
| en.wikipedia.org(Web scraping) | 200 | 200 | 200,1.9 秒 |
| github.com(scrapy 仓库) | 200 | 200 | 200,2.0 秒 |
| bbc.com(Technology) | 302 重定向 | 302 重定向 | 200,1.4 秒 |
BBC 行不是阻止。我们的测试客户端没有跟随重定向,而 302 是站点将您发送到另一个 URL。requests 默认跟随重定向并着陆在页面上。
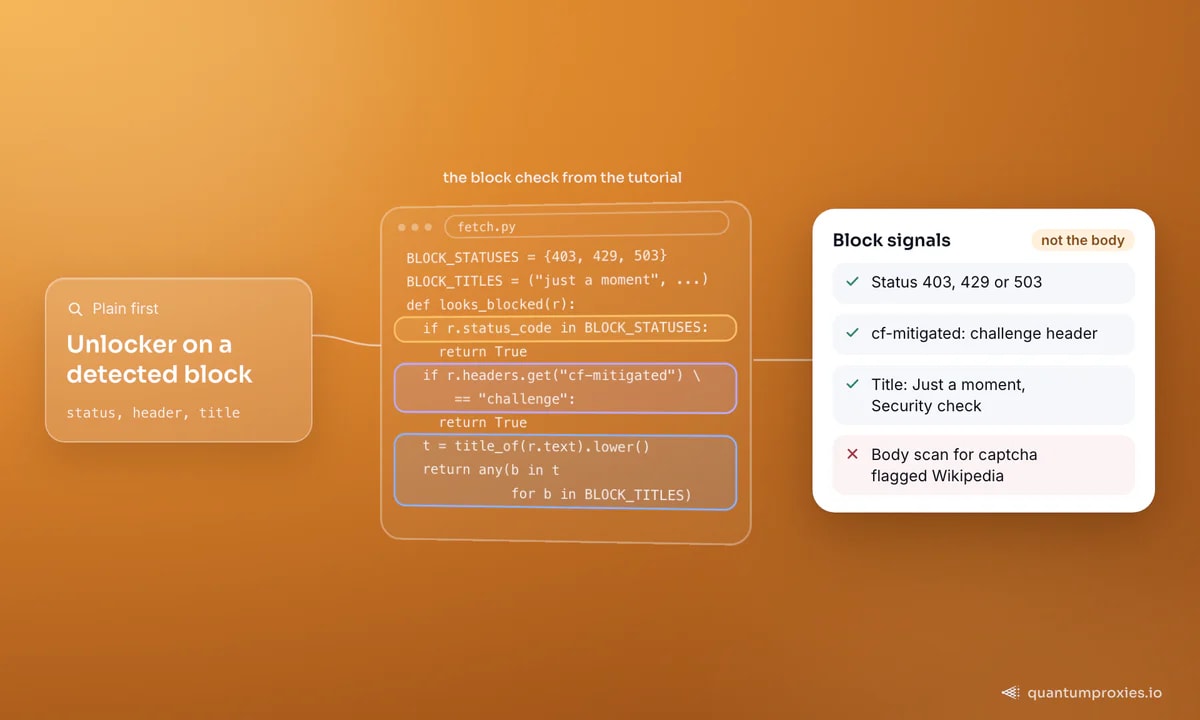
所以正确的模式是先尝试普通请求,在检测到阻止时使用 Unlocker。检测需要小心。我们自己的测试工具中的标记扫描将 Wikipedia 和 GitHub 页面标记为被阻止,因为它们的正文包含“captcha”一词,尽管两者都返回了真实页面和 200。检查状态码、Cloudflare 的 cf-mitigated 头和页面标题,而不是整个正文:
from urllib.parse import urlsplit

BLOCK_STATUSES = {403, 429, 503}
BLOCK_TITLES = (
    "just a moment",                        # Cloudflare challenge
    "attention required",                   # Cloudflare block page
    "access denied",                        # Akamai and others
    "security check",
    "access to this page has been denied",  # PerimeterX
)
needs_unlocker: set[str] = set()            # domains that blocked plain requests


def looks_blocked(r: requests.Response) -> bool:
    if r.status_code in BLOCK_STATUSES:
        return True
    if r.headers.get("cf-mitigated") == "challenge":
        return True
    return any(t in title_of(r.text).lower() for t in BLOCK_TITLES)


def fetch(url: str, session_id: str | None = None) -> tuple[requests.Response, str]:
    host = urlsplit(url).hostname or ""
    if host not in needs_unlocker:
        try:
            r = requests.get(url, headers=HEADERS, timeout=20)
            if not looks_blocked(r):
                return r, "plain"
        except requests.RequestException:
            pass  # a reset or a timeout counts as a block too
        needs_unlocker.add(host)
    return unlock_get(url, session_id), "unlocker"   # from step 4; raises Blocked


for u in ("https://docs.python.org/3/library/urllib.request.html", URL):
    resp, route = fetch(u)
    print(route, resp.status_code, title_of(resp.text)[:60])
except 分支很重要。Best Buy 的笔记本电脑类别从未给我们的普通客户端任何 HTTP 响应:从数据中心服务器和住宅代理连接都失败了。通过 Unlocker,相同的 URL 在第一次尝试中返回了 200,耗时 6.3 秒。仅检查状态码的爬虫永远不会升级那个。
测量结果:四个需要 Unlocker 的网站
在 2026 年 9 月 29 日测量。普通请求是带有 Chrome User-Agent 的 curl,一次从法兰克福的数据中心服务器,一次通过具有美国出口的住宅代理。Web Unlocker 请求使用具有美国出口的住宅层。时间是单次请求的墙钟时间。
| 网站 | 普通,数据中心服务器 | 普通,住宅代理 | Web Unlocker |
|---|---|---|---|
| Indeed(职位搜索) | 403,“Security Check”页面 | 403,“启用 JavaScript 和 cookies 以继续” | 200,1 次尝试,2.6 秒 |
| Glassdoor(公司评论) | 403,“Security”页面带验证码 | 403,“启用 JavaScript 和 cookies 以继续” | 200,2 次尝试 + 浏览器,17.2 秒 |
| Walmart(搜索) | 307 重定向,无结果页面 | 307 重定向,无结果页面 | 200,1 次尝试,4.8 秒 |
| Best Buy(笔记本电脑类别) | 连接失败,无响应 | 连接失败,无响应 | 200,1 次尝试,6.3 秒 |
简而言之:Indeed、Walmart 和 Best Buy 在没有浏览器的情况下通过了第一次 TLS 尝试。Glassdoor 需要完整路径,两次 TLS 尝试,然后是无头浏览器来回答 JavaScript 挑战,这就是为什么它花了 17.2 秒。对于 Walmart,我们没有记录 307 指向的位置。我们可以说的是,普通客户端都没有收到结果页面,而 Unlocker 收到了。
对受挑战保护的站点的重复请求在您固定会话时会更快。发送相同的 x-qp-session 值,或在代理用户名中保持相同的 -session-<id>,浏览器获得的清除 cookie 会被重用。在 2026 年 9 月 29 日的 Glassdoor 测试中,用户名中固定会话和两个单独连接,第一次请求通过浏览器耗时 14.0 秒,第二次 1.4 秒,x-qp-clearance: hit。我们的Indeed 职位发布爬取指南涵盖了获取页面后的操作。
如果您从一个仅在浏览器外发生的 403 到达这里,我们的为什么 curl 得到 403 而浏览器工作的解释深入探讨了诊断。有关您实际需要哪个层的逐站点查看,请参见web unlocker vs residential proxy, tested。
常见问题
是否有免费的 Web Unlocker API?
开源部分是免费的:requests、curl_cffi 用于类似浏览器的 TLS,以及 Playwright 用于真实浏览器。良好运行它们是工作,因为您还需要干净的出口 IP 和用于 JavaScript 挑战的浏览器。在 QuantumProxies.io 上,创建账户是免费的,Unlocker 流量按每 GB 从您在仪表板中充值的预付余额中扣费。
可以使用 Python 爬取 Glassdoor 或 Zillow 吗?
在我们 2026 年 9 月 29 日的测试中,普通请求到 Glassdoor 评论页面从数据中心服务器和住宅代理都得到了 403,Unlocker 在浏览器升级后返回了页面。Zillow 阻止了数据中心服务器,但通过普通住宅代理提供了页面。在收集任何内容之前,请检查每个网站的条款。
网络爬虫可以被检测到吗?
是的。网站会评分 IP 的网络类型和历史记录、TLS 握手、HTTP/2 设置、头顺序以及在挑战页面上 JavaScript 报告的浏览器信息。普通 Python 请求在多个方面同时失败。这就是为什么仅更改 User-Agent 很少有帮助,以及为什么 Unlocker 更改 IP、指纹以及在需要时更改整个客户端。
我需要安装证书才能使用正向代理吗?
只有通过经典正向代理的 HTTPS,因为 Unlocker 终止 TLS 以重写请求。要么跳过该会话的验证(Python 中的 verify=False,curl 中的 -k),要么使用您的 API 密钥从 /api/v1/scraper/unlock/ca 下载 CA 并信任它。REST 端点根本不需要证书。
如何在多个请求中保持相同的 IP?
在每个请求中通过正向代理发送相同的 x-qp-session 头值,或在代理用户名中放置相同的 -session-<id>。共享该会话的调用从相同的出口离开,并且浏览器获得的清除 cookie 被重用。在 REST 端点上,传递一个 sessionId 并将 rotation 设置为 sticky。一个粘性会话可以持续 3 到 1,440 分钟。
整个模式可以用一句话概括:简单获取,通过状态、头和标题检测阻止,仅将那些 URL 通过 Unlocker 发送,并记录 x-qp 头,以便您知道每个页面的成本。首先使用住宅层,并将移动层保留给拒绝住宅范围的目标。