Учебное пособие по Web Unlocker API: Python и Node.js, заблокированные и разблокированные сайты
Рабочий код на Python и Node.js для Web Unlocker API: один и тот же запрос к сайту, который блокирует простых клиентов, и к сайту, который этого не делает, как читать отчеты unlocker и помощник, который оплачивает unlocker только при обнаружении блока.
Web Unlocker API воспроизводит HTTP-запрос с резидентного IP под отпечатком TLS браузера, повторяя попытку с новым IP и переключаясь на реальный браузер, когда сайт отвечает вызовом. Это учебное пособие по Web Unlocker API показывает его на Python и Node.js, на сайте, который блокирует простых клиентов, и на сайте, который этого не делает.
Каждый результат, приведенный ниже, был измерен 29 сентября 2026 года: тот же URL, полученный с помощью простого curl с сервером в датацентре во Франкфурте, с помощью простого curl через резидентный прокси с выходом в США и через Web Unlocker QuantumProxies.io с выходом в США. Там, где сайт не нуждался в unlocker, мы об этом говорим, потому что самый дешевый запрос — это тот, который работает без него.
- Два способа доступа: прямой прокси на
unlock.quantumproxies.io:9000для кода, который уже использует прокси-протокол, илиPOST /api/v1/scraper/unlockс вашим API-ключом для всего остального. - Что вы получаете в ответ: статус, заголовки и тело источника, плюс заголовки
x-qp-*, указывающие, сколько попыток потребовалось, запускался ли браузер и какая стена его остановила, если таковая была. - Когда он не нужен: Wikipedia, GitHub, docs.python.org, Hacker News и books.toscrape.com все ответили на простые запросы в нашем тесте. Попробуйте сначала простой запрос и используйте unlocker только при обнаружении блока.
Что вам нужно перед началом
- Аккаунт QuantumProxies.io с трафиком Web Unlocker. Unlocker списывает средства с предоплаченного баланса в ГБ, отдельно для резидентного и мобильного уровня (выходы 4G/5G).
- Для прямого прокси: под-пользователь прокси, созданный на странице Web Unlocker в панели управления. Он выглядит как
unlock-XXXXXXXXс собственным паролем. Это не ваш API-ключ. - Для REST-эндпоинта: API-ключ из панели управления, отправляемый как
Authorization: Bearer. - Python 3.10 или новее с
requests, и для части на Node.js Node 18 или новее с пакетомundici.
Храните оба секрета в переменных окружения. Примеры читают QP_UNLOCK_USER, QP_UNLOCK_PASSWORD и QP_API_KEY. Если пароль прокси содержит такие символы, как @ или :, закодируйте его в URL с помощью urllib.parse.quote перед добавлением в URL прокси.
Шаг 1: увидеть блокировку с помощью простых запросов Python
Начните с неудачи, чтобы знать, что вы исправляете. Цель — поиск работы на Indeed. С нашего сервера в датацентре во Франкфурте он ответил 403 страницей с заголовком 'Security Check - Indeed.com'. Через простой резидентный прокси он все равно ответил 403, на этот раз с телом, просящим клиента 'Enable JavaScript and cookies to continue'. Чистый домашний IP не помог.
import re
import requests

URL = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX"
HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/150.0.0.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}


def title_of(html: str) -> str:
    m = re.search(r"<title[^>]*>(.*?)</title>", html, re.I | re.S)
    return m.group(1).strip() if m else ""


r = requests.get(URL, headers=HEADERS, timeout=30)
print(r.status_code, "|", title_of(r.text))
# Our datacenter run on 29 Sep 2026 saw: 403 | Security Check - Indeed.com
Наше измерение использовало curl с User-Agent Chrome, а не requests, и нет причин ожидать, что requests справится лучше. Строка User-Agent — это один заголовок. Антибот-слой также читает рукопожатие TLS и настройки HTTP/2, и они все равно указывают на Python, независимо от того, какой User-Agent вы установите. Вот почему замена заголовков редко помогает обойти обнаружение ботов в Python requests; сторона рукопожатия освещена в нашем руководстве по TLS-фингерпринтингу и почему чистые IP все равно блокируются. 403 означает, что сервер понял запрос и отказал в нем (RFC 9110, раздел 15.5.4). Это не значит, что ваш URL или параметры неверны.
Шаг 2: тот же вызов через прямой прокси
Прямой прокси — это минимальное изменение существующего кода: передайте его как прокси, и ничего больше не меняется. Целевое направление передается в имени пользователя. -country-us выбирает страну выхода, -tier-mobile переключается на мобильные выходы, а -profile-firefox (или chrome, safari, safariios, edge, brave, mobile) закрепляет один отпечаток TLS вместо того, чтобы позволять повторным попыткам его вращать.
import os
import requests
import urllib3

urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

user = os.environ["QP_UNLOCK_USER"] + "-country-us"   # e.g. unlock-XXXXXXXX-country-us
password = os.environ["QP_UNLOCK_PASSWORD"]
PROXY = f"http://{user}:{password}@unlock.quantumproxies.io:9000"

r = requests.get(
    URL,
    headers=HEADERS,
    proxies={"http": PROXY, "https": PROXY},
    verify=False,   # or verify="qp-unlocker-ca.pem", see below
    timeout=120,
)
print(r.status_code, "|", title_of(r.text))
print("attempts:", r.headers.get("x-qp-unlocker-attempts"),
      "rendered:", r.headers.get("x-qp-unlocker-rendered"))
29 сентября это вернуло 200 с реальной страницей результатов, заголовок которой 'Now Hiring: 2,000 Data Engineer Jobs in Austin, TX | Indeed', на первой попытке TLS, за 2,6 секунды, без запуска браузера.
Почему verify=False? Чтобы переписать HTTPS-запрос, unlocker должен завершить TLS вашего клиента и представить свой собственный сертификат для целевого хоста. У вас есть два чистых варианта. Отключите проверку только для этой сессии, как выше, что делает curl -k. Или скачайте unlocker CA один раз и доверьтесь ему явно, чтобы проверка оставалась включенной:
curl -H "Authorization: Bearer $QP_API_KEY" \
  -o qp-unlocker-ca.pem https://app.quantumproxies.io/api/v1/scraper/unlock/ca
Затем передайте verify="qp-unlocker-ca.pem" вместо False. Документация по расширенному использованию requests охватывает как аргумент proxies, так и пользовательские пакеты CA. Если вы не хотите ни того, ни другого, REST-эндпоинт ниже не требует сертификата вообще.
Шаг 3: REST-эндпоинт, без прокси-протокола
REST-эндпоинт запускает тот же движок за обычным HTTPS-вызовом. Вы описываете запрос, который бы сделали (url, метод, заголовки, тело), и получаете ответ источника в формате JSON. Единственное обязательное поле — url.
import os
import requests

API_KEY = os.environ["QP_API_KEY"]

resp = requests.post(
    "https://app.quantumproxies.io/api/v1/scraper/unlock",
    headers={"Authorization": f"Bearer {API_KEY}"},
    json={
        "url": URL,
        "country": "us",
        # "tier": "mobile",        # mobile exits, billed on the mobile balance
        # "failOnBlock": True,     # HTTP 502 instead of 200 when every tier was blocked
    },
    timeout=130,
)
resp.raise_for_status()           # 402 = no unlocker GB left, 400 = bad input
data = resp.json()["payload"]

print(data["status"], "blocked:", data["blocked"])
print("attempts:", data["attempts"], "rendered:", data["rendered"],
      "escalated:", data["escalated"], "clearance:", data.get("clearance"))
if data["blocked"]:
    print("block class:", data.get("blockClass"), "vendor:", data.get("vendor"))
html = data.get("body") or ""     # text form; bodyBase64 is always present too
Оболочка ответа — это { type, message, payload }. Внутри payload вы получаете status (код статуса источника), headers, body и bodyBase64, finalUrl, отпечаток profile, attempts, rendered, escalated, blocked и, когда что-то остановило запрос, blockClass и vendor. Объект usage сообщает о байтах, списанных за вызов.
Одно поведение, которое нужно учитывать: по умолчанию, запрос, который остался заблокированным после каждой попытки, все равно возвращается от API как HTTP 200, с blocked: true и страницей блокировки в body для инспекции. Он маркирован, а не замаскирован. Если ваша система обрабатывает любой 200 как успех, установите failOnBlock: true, и вы получите 502 с теми же диагностическими данными вместо этого. Другие поля, которые стоит знать: method и body для POST-запросов, render: "html" для запуска в браузере, waitForSelector и returnCookies.
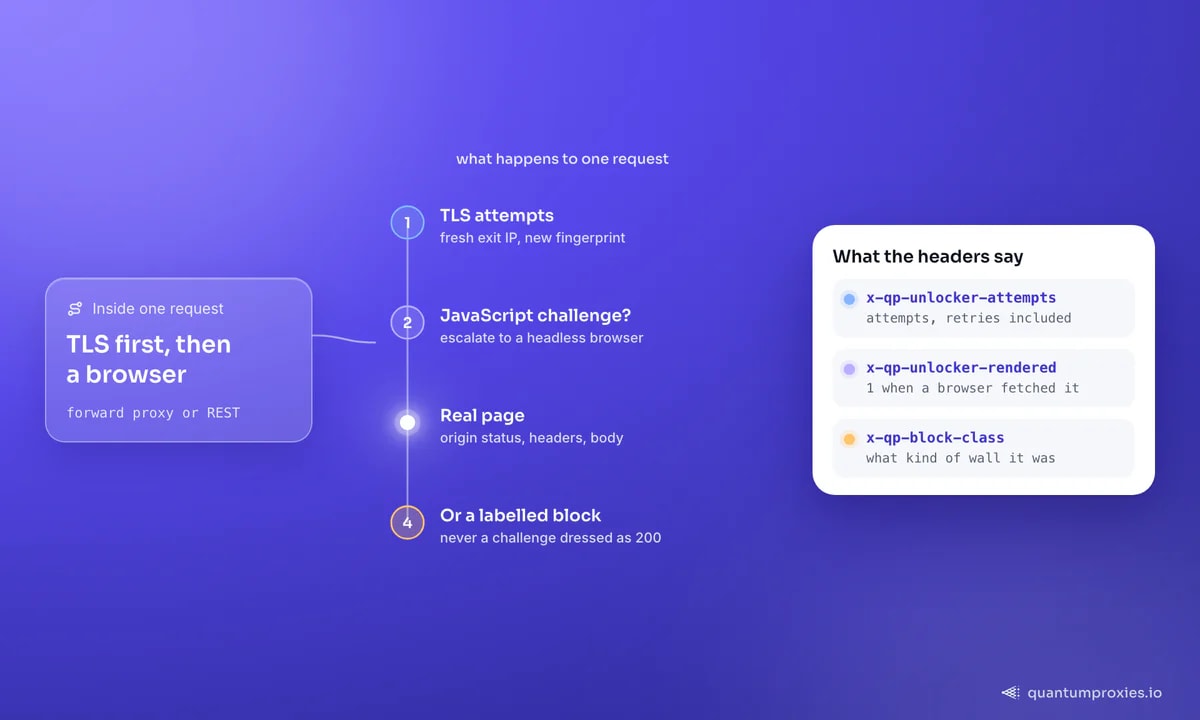
Посмотрите, как Web Unlocker обрабатывает заблокированные запросы
Шаг 4: читайте заголовки x-qp и обрабатывайте сообщенный блок
Через прямой прокси unlocker сообщает о самом ответе. Это заголовки, которые стоит логировать при каждом вызове:
| Заголовок | Что он сообщает |
|---|---|
| x-qp-unlocker-attempts | Сколько попыток потребовалось для запроса, включая повторные попытки |
| x-qp-unlocker-rendered / x-qp-unlocker-escalated | Установлен в 1, когда безголовый браузер получил страницу / когда запрос поднялся с уровня TLS |
| x-qp-unlocker-profile | Какой отпечаток браузера использовался для возвращенной попытки |
| x-qp-clearance | Что произошло с кэшем разрешений браузера при этом вызове: minted, hit или miss |
| x-qp-session / x-qp-country | Сессия выхода и страна, фактически использованные |
| x-qp-unlocker-blocked | Присутствует только тогда, когда страница осталась заблокированной после каждой попытки |
| x-qp-block-class / x-qp-vendor | Какой тип стены это был и какой антибот-вендор, если он распознан |
Страница, которая все еще заблокирована, никогда не приходит как тихий 200. Если источник отказал с собственной ошибкой (403, 429, 503), этот статус передается без изменений с установленным x-qp-unlocker-blocked. Если источник предоставил страницу вызова с 2xx, прокси превращает ее в 502 и помещает код источника в x-qp-origin-status. Таким образом, одна проверка охватывает оба случая:
class Blocked(Exception):
    pass


s = requests.Session()
s.proxies = {"http": PROXY, "https": PROXY}
s.verify = False  # or "qp-unlocker-ca.pem"

NEXT_STEP = {
    "js_challenge":  "a browser could not clear it; retry later in a pinned session",
    "captcha":       "interactive captcha; decide in your own code",
    "access_denied": "the site denied access; retry with a fresh session or test tier-mobile",
    "rate_limited":  "the site is rate limiting; slow down and retry later",
    "fingerprint":   "the client fingerprint was refused; retry with another profile",
    "geo":           "the content depends on location; set the country explicitly",
    "timeout":       "the target was too slow; raise x-qp-timeout or retry",
}


def unlock_get(url: str, session_id: str | None = None) -> requests.Response:
    headers = {"x-qp-session": session_id} if session_id else {}
    r = s.get(url, headers=headers, timeout=120)
    if "x-qp-unlocker-blocked" in r.headers:
        cls = r.headers.get("x-qp-block-class", "unknown")
        raise Blocked(
            f"{url}: HTTP {r.status_code}, class={cls}, "
            f"vendor={r.headers.get('x-qp-vendor')}, next: {NEXT_STEP.get(cls, 'inspect the body')}"
        )
    return r
Шаг 5: версия на Node.js (web unlocker API на JavaScript)
В Node, fetch принимает dispatcher. Используйте ProxyAgent из undici для прямого прокси и импортируйте fetch из того же пакета, чтобы обе версии совпадали. Документация ProxyAgent перечисляет используемые здесь параметры: token для значения Proxy-Authorization и requestTls для настроек TLS по отношению к цели.
// unlock.mjs  (npm i undici)
import { readFileSync } from "node:fs";
import { fetch, ProxyAgent } from "undici";

const user = process.env.QP_UNLOCK_USER + "-country-us";
const pass = process.env.QP_UNLOCK_PASSWORD;

const dispatcher = new ProxyAgent({
  uri: "http://unlock.quantumproxies.io:9000",
  token: "Basic " + Buffer.from(user + ":" + pass).toString("base64"),
  requestTls: { rejectUnauthorized: false },
  // verified instead: requestTls: { ca: readFileSync("qp-unlocker-ca.pem") },
});

const url = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX";
const res = await fetch(url, { dispatcher, headers: { "x-qp-session": "indeed-001" } });

if (res.headers.get("x-qp-unlocker-blocked")) {
  console.error("blocked:", res.status, res.headers.get("x-qp-block-class"), res.headers.get("x-qp-vendor"));
} else {
  const html = await res.text();
  console.log(res.status, res.headers.get("x-qp-unlocker-attempts"), html.length);
}
REST-эндпоинт не требует ничего, кроме fetch, встроенного в Node 18+:
const resp = await fetch("https://app.quantumproxies.io/api/v1/scraper/unlock", {
  method: "POST",
  headers: {
    Authorization: "Bearer " + process.env.QP_API_KEY,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({ url: "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX", country: "us" }),
});
const { payload } = await resp.json();
console.log(payload.status, payload.blocked, payload.blockClass ?? "-", payload.attempts);
В axios, обычный шаблон для HTTPS-целей за прокси — это передать агент из https-proxy-agent как httpsAgent и установить proxy: false, или вызвать REST-эндпоинт выше и полностью избежать прокси-протокола.
Шаг 6: когда unlocker не нужен
Unlocker тарифицируется по ГБ за каждый байт, который он перемещает, включая повторные попытки и загрузки страниц браузера. Отправка ему страниц, которые простой запрос получает нормально, сжигает баланс впустую. В нашем запуске эти вернулись нормально без какой-либо помощи:
| Сайт | Простой, сервер в датацентре | Простой, резидентный прокси | Web Unlocker |
|---|---|---|---|
| docs.python.org (страница urllib.request) | 200 | 200 | 200, 1,6 с |
| books.toscrape.com | 200 | 200 | 200, 1,9 с |
| news.ycombinator.com | 200 | 200 | 200, 4,1 с |
| en.wikipedia.org (Web scraping) | 200 | 200 | 200, 1,9 с |
| github.com (репозиторий scrapy) | 200 | 200 | 200, 2,0 с |
| bbc.com (Технологии) | 302 redirect | 302 redirect | 200, 1,4 с |
Строка BBC не является блокировкой. Наш тестовый клиент не следовал за перенаправлениями, и 302 — это сайт, отправляющий вас на другой URL. requests по умолчанию следует за перенаправлениями и попадает на страницу.
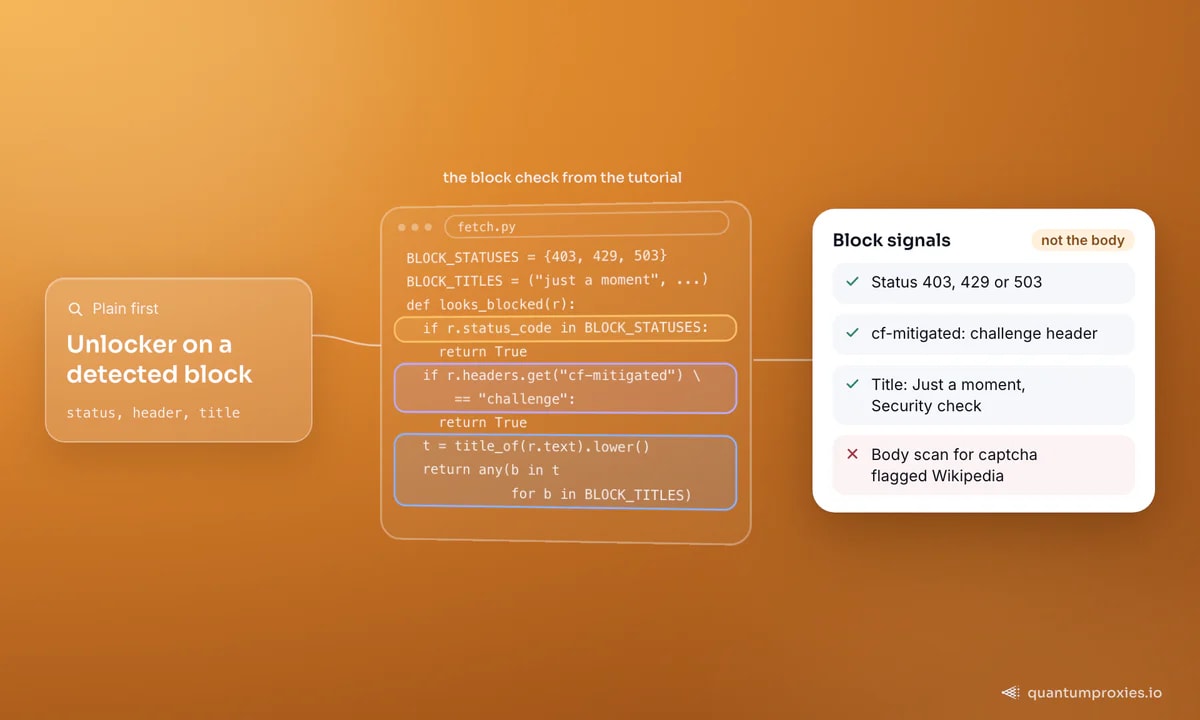
Таким образом, правильный шаблон — сначала простой запрос, unlocker при обнаружении блока. Обнаружение требует осторожности. Сканер маркеров в нашем собственном тестовом окружении отметил страницы Wikipedia и GitHub как заблокированные, потому что их тела содержат слово 'captcha', хотя обе вернули реальную страницу с 200. Проверьте код статуса, заголовок Cloudflare cf-mitigated и заголовок страницы, а не все тело:
from urllib.parse import urlsplit

BLOCK_STATUSES = {403, 429, 503}
BLOCK_TITLES = (
    "just a moment",                        # Cloudflare challenge
    "attention required",                   # Cloudflare block page
    "access denied",                        # Akamai and others
    "security check",
    "access to this page has been denied",  # PerimeterX
)
needs_unlocker: set[str] = set()            # domains that blocked plain requests


def looks_blocked(r: requests.Response) -> bool:
    if r.status_code in BLOCK_STATUSES:
        return True
    if r.headers.get("cf-mitigated") == "challenge":
        return True
    return any(t in title_of(r.text).lower() for t in BLOCK_TITLES)


def fetch(url: str, session_id: str | None = None) -> tuple[requests.Response, str]:
    host = urlsplit(url).hostname or ""
    if host not in needs_unlocker:
        try:
            r = requests.get(url, headers=HEADERS, timeout=20)
            if not looks_blocked(r):
                return r, "plain"
        except requests.RequestException:
            pass  # a reset or a timeout counts as a block too
        needs_unlocker.add(host)
    return unlock_get(url, session_id), "unlocker"   # from step 4; raises Blocked


for u in ("https://docs.python.org/3/library/urllib.request.html", URL):
    resp, route = fetch(u)
    print(route, resp.status_code, title_of(resp.text)[:60])
Ветка except имеет значение. Категория ноутбуков Best Buy никогда не давала нашим простым клиентам HTTP-ответа вообще: соединение не удалось как с сервера в датацентре, так и через резидентный прокси. Через unlocker тот же URL вернулся 200 с первой попытки за 6,3 секунды. Скрапер, который проверяет только коды статуса, никогда бы не эскалировал это.
Измеренные результаты: четыре сайта, которые нуждались в unlocker
Измерено 29 сентября 2026 года. Простые запросы были curl с User-Agent Chrome, один раз с сервера в датацентре во Франкфурте и один раз через резидентный прокси с выходом в США. Запросы Web Unlocker использовали резидентный уровень с выходом в США. Время указано по часам для одного запроса.
| Сайт | Простой, сервер в датацентре | Простой, резидентный прокси | Web Unlocker |
|---|---|---|---|
| Indeed (поиск работы) | 403, страница 'Security Check' | 403, 'Enable JavaScript and cookies to continue' | 200, 1 попытка, 2,6 с |
| Glassdoor (обзоры компаний) | 403, страница 'Security' с капчей | 403, 'Enable JavaScript and cookies to continue' | 200, 2 попытки + браузер, 17,2 с |
| Walmart (поиск) | 307 redirect, нет страницы результатов | 307 redirect, нет страницы результатов | 200, 1 попытка, 4,8 с |
| Best Buy (категория ноутбуков) | Соединение не удалось, нет ответа | Соединение не удалось, нет ответа | 200, 1 попытка, 6,3 с |
Вкратце: Indeed, Walmart и Best Buy прошли с первой попытки TLS без браузера. Glassdoor потребовал полный путь, две попытки TLS и затем безголовый браузер, чтобы ответить на вызов JavaScript, поэтому это заняло 17,2 секунды. Для Walmart мы не записали, куда указывал 307. Что мы можем сказать, так это то, что ни один из простых клиентов не получил страницу результатов, а unlocker получил.
Повторные запросы к сайту, защищенному вызовами, становятся быстрее, когда вы закрепляете сессию. Отправьте то же значение заголовка x-qp-session, или сохраните тот же -session-<id> в имени пользователя прокси, и cookie разрешения, полученное браузером, будет повторно использовано. В тесте Glassdoor 29 сентября 2026 года, с закрепленной сессией в имени пользователя и двумя отдельными соединениями, первый запрос занял 14,0 секунды через браузер, а второй 1,4 секунды, с x-qp-clearance: hit. Наше руководство по скрапингу объявлений о работе Indeed охватывает, что делать с страницей, как только вы ее получите.
Если вы пришли сюда из-за 403, который происходит только за пределами браузера, наше объяснение на почему curl получает 403, когда браузер работает углубляется в диагностику. Для анализа по сайтам, какой уровень вам действительно нужен, см. web unlocker против резидентного прокси, тестирование.
Часто задаваемые вопросы
Существует ли бесплатный Web Unlocker API?
Открытые компоненты бесплатны: requests, curl_cffi для TLS, похожего на браузер, и Playwright для реального браузера. Их правильная работа — это работа, потому что вам также нужны чистые выходные IP и браузер для вызовов JavaScript. На QuantumProxies.io создание аккаунта бесплатно, а трафик unlocker тарифицируется по ГБ с предоплаченного баланса, который вы пополняете в панели управления.
Можно ли скрапить Glassdoor или Zillow с помощью Python?
В нашем тесте 29 сентября 2026 года простые запросы к странице обзоров Glassdoor получили 403 как с сервера в датацентре, так и через резидентный прокси, а unlocker вернул страницу после эскалации браузера. Zillow заблокировал сервер в датацентре, но предоставил страницу через простой резидентный прокси. Проверьте условия каждого сайта перед сбором чего-либо.
Может ли веб-скрапинг быть обнаружен?
Да. Сайты оценивают тип и историю сети IP, рукопожатие TLS, настройки HTTP/2, порядок заголовков и, на страницах вызовов, что JavaScript сообщает о браузере. Простой запрос Python проваливает несколько из этих проверок одновременно. Вот почему изменение только User-Agent редко помогает, и почему unlocker меняет IP, отпечаток и, при необходимости, весь клиент.
Нужно ли устанавливать сертификат для использования прямого прокси?
Только для HTTPS через классический прямой прокси, потому что unlocker завершает TLS для переписывания запроса. Либо пропустите проверку для этой сессии (verify=False в Python, -k в curl), либо скачайте CA с /api/v1/scraper/unlock/ca с вашим API-ключом и доверьтесь ему. REST-эндпоинт не требует сертификата вообще.
Как сохранить тот же IP для нескольких запросов?
Отправьте то же значение заголовка x-qp-session на каждый запрос через прямой прокси, или поместите тот же -session-<id> в имя пользователя прокси. Вызовы, разделяющие эту сессию, выходят с того же выхода, и cookie разрешения, полученное браузером, повторно используется. На REST-эндпоинте передайте sessionId с rotation, установленным в sticky. Sticky-сессия может длиться от 3 до 1 440 минут.
Весь шаблон умещается в одно предложение: получайте страницы просто, обнаруживайте блокировку по статусу, заголовку и заголовку страницы, отправляйте только эти URL через unlocker и логируйте заголовки x-qp, чтобы знать, сколько стоила каждая страница. Начните с резидентного уровня и держите мобильный уровень для целей, которые также отказываются от резидентных диапазонов.