Samouczek API Web Unlocker: Python i Node.js, Zablokowane vs Odblokowane
Działający kod w Python i Node.js dla API web unlocker: to samo żądanie do strony, która blokuje zwykłych klientów i takiej, która tego nie robi, jak odczytać raporty unlockera oraz pomocnik, który płaci za unlocker tylko wtedy, gdy wykryto blokadę.
API web unlocker odtwarza żądanie HTTP z IP rezydencyjnego pod odciskiem palca TLS przeglądarki, ponawiając na nowym IP i przełączając się na prawdziwą przeglądarkę, gdy strona odpowiada wyzwaniem. Ten samouczek API web unlocker pokazuje to w Python i Node.js, na stronie, która blokuje zwykłych klientów i takiej, która tego nie robi.
Każdy wynik cytowany poniżej został zmierzony 29 września 2026: ten sam URL pobrany zwykłym curl z serwera centrum danych we Frankfurcie, zwykłym curl przez proxy rezydencyjne z wyjściem w USA oraz przez Web Unlocker QuantumProxies.io z wyjściem w USA. Gdzie strona nie potrzebowała unlockera, mówimy o tym, ponieważ najtańsze żądanie to takie, które działa bez niego.
- Dwa sposoby wejścia: forward proxy na
unlock.quantumproxies.io:9000dla kodu, który już obsługuje protokół proxy, lubPOST /api/v1/scraper/unlockz kluczem API dla wszystkiego innego. - Co otrzymujesz z powrotem: status, nagłówki i ciało pochodzenia, plus nagłówki
x-qp-*mówiące, ile prób to zajęło, czy uruchomiono przeglądarkę i jaki rodzaj ściany to zatrzymał, jeśli tak się stało. - Czego nie robi: interaktywne captchy (suwaki, przytrzymaj, siatki obrazów) nie są rozwiązywane. Żądanie kończy się niepowodzeniem zamiast przekazywać stronę captcha jako 200, a punkt końcowy REST oznacza to klasą blokady
captcha. - Kiedy go nie potrzebujesz: Wikipedia, GitHub, docs.python.org, Hacker News i books.toscrape.com wszystkie odpowiedziały na zwykłe żądania w naszym teście. Spróbuj najpierw zwykłego i eskaluj tylko przy wykrytej blokadzie.
Co potrzebujesz przed rozpoczęciem
- Konto QuantumProxies.io z przepustowością Web Unlocker. Unlocker nalicza opłaty z przedpłaconego salda GB, osobno dla poziomu rezydencyjnego i mobilnego (wyjścia operatorów 4G/5G).
- Dla forward proxy: sub-użytkownik proxy utworzony na stronie Web Unlocker w panelu. Wygląda jak
unlock-XXXXXXXXz własnym hasłem. To nie jest twój klucz API. - Dla punktu końcowego REST: klucz API z panelu, przesłany jako
Authorization: Bearer. - Python 3.10 lub nowszy z
requests, a dla części Node.js Node 18 lub nowszy z pakietemundici.
Przechowuj oba sekrety w zmiennych środowiskowych. Przykłady odczytują QP_UNLOCK_USER, QP_UNLOCK_PASSWORD i QP_API_KEY. Jeśli hasło proxy zawiera znaki takie jak @ lub :, zakoduj je w URL za pomocą urllib.parse.quote zanim umieścisz je w URL proxy.
Krok 1: zobacz blokadę za pomocą zwykłych żądań Python
Zacznij od niepowodzenia, aby wiedzieć, co naprawiasz. Celem jest wyszukiwanie pracy w Indeed. Z naszego serwera centrum danych we Frankfurcie odpowiedziało 403 stroną zatytułowaną 'Security Check - Indeed.com'. Przez zwykłe proxy rezydencyjne nadal odpowiedziało 403, tym razem z ciałem proszącym klienta o 'Enable JavaScript and cookies to continue'. Czyste domowe IP nie wystarczyło.
import re
import requests

URL = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX"
HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/150.0.0.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}


def title_of(html: str) -> str:
    m = re.search(r"<title[^>]*>(.*?)</title>", html, re.I | re.S)
    return m.group(1).strip() if m else ""


r = requests.get(URL, headers=HEADERS, timeout=30)
print(r.status_code, "|", title_of(r.text))
# Our datacenter run on 29 Sep 2026 saw: 403 | Security Check - Indeed.com
Nasze pomiary używały curl z User-Agent Chrome, nie requests, i nie ma powodu oczekiwać, że requests poradzi sobie lepiej. Ciąg User-Agent to jeden nagłówek. Warstwa anty-botowa odczytuje również handshake TLS i ustawienia HTTP/2, a te nadal mówią Python, niezależnie od tego, jaki User-Agent ustawisz. Dlatego zamiana nagłówków rzadko pozwala przejść wykrywanie bota w Python requests; strona handshake jest omówiona w naszym przewodniku po TLS fingerprinting i dlaczego czyste IP są nadal blokowane. 403 oznacza, że serwer zrozumiał żądanie i odmówił go (RFC 9110, sekcja 15.5.4). Nie oznacza to, że twój URL lub twoje parametry są błędne.
Krok 2: to samo wywołanie przez forward proxy
Forward proxy to najmniejsza zmiana w istniejącym kodzie: przekaż je jako proxy i nic innego się nie zmienia. Celowanie jedzie w nazwie użytkownika. -country-us wybiera kraj wyjścia, -tier-mobile przełącza na wyjścia mobilne, a -profile-firefox (lub chrome, safari, safariios, edge, brave, mobile) przypina jeden odcisk palca TLS zamiast pozwalać na rotację przy ponowieniach.
import os
import requests
import urllib3

urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

user = os.environ["QP_UNLOCK_USER"] + "-country-us"   # e.g. unlock-XXXXXXXX-country-us
password = os.environ["QP_UNLOCK_PASSWORD"]
PROXY = f"http://{user}:{password}@unlock.quantumproxies.io:9000"

r = requests.get(
    URL,
    headers=HEADERS,
    proxies={"http": PROXY, "https": PROXY},
    verify=False,   # or verify="qp-unlocker-ca.pem", see below
    timeout=120,
)
print(r.status_code, "|", title_of(r.text))
print("attempts:", r.headers.get("x-qp-unlocker-attempts"),
      "rendered:", r.headers.get("x-qp-unlocker-rendered"))
29 września to zwróciło 200 z rzeczywistą stroną wyników, zatytułowaną 'Now Hiring: 2,000 Data Engineer Jobs in Austin, TX | Indeed', przy pierwszej próbie TLS, w 2,6 sekundy, bez uruchamiania przeglądarki.
Dlaczego verify=False? Aby przepisać żądanie HTTPS, unlocker musi zakończyć TLS twojego klienta i przedstawić własny certyfikat dla docelowego hosta. Masz dwie czyste opcje. Wyłącz weryfikację tylko dla tej sesji, jak powyżej, co robi curl -k. Lub pobierz raz CA unlockera i zaufaj mu explicite, aby weryfikacja pozostała włączona:
curl -H "Authorization: Bearer $QP_API_KEY" \
  -o qp-unlocker-ca.pem https://app.quantumproxies.io/api/v1/scraper/unlock/ca
Następnie przekaż verify="qp-unlocker-ca.pem" zamiast False. Dokumentacja zaawansowanego użycia requests obejmuje zarówno argument proxies, jak i niestandardowe pakiety CA. Jeśli nie chcesz żadnego z nich, poniższy punkt końcowy REST nie potrzebuje żadnego certyfikatu.
Krok 3: punkt końcowy REST, bez protokołu proxy
Punkt końcowy REST uruchamia ten sam silnik za normalnym wywołaniem HTTPS. Opisujesz żądanie, które byś wykonał (url, metoda, nagłówki, ciało) i otrzymujesz odpowiedź pochodzenia jako JSON. Jedynym wymaganym polem jest url.
import os
import requests

API_KEY = os.environ["QP_API_KEY"]

resp = requests.post(
    "https://app.quantumproxies.io/api/v1/scraper/unlock",
    headers={"Authorization": f"Bearer {API_KEY}"},
    json={
        "url": URL,
        "country": "us",
        # "tier": "mobile",        # mobile exits, billed on the mobile balance
        # "failOnBlock": True,     # HTTP 502 instead of 200 when every tier was blocked
    },
    timeout=130,
)
resp.raise_for_status()           # 402 = no unlocker GB left, 400 = bad input
data = resp.json()["payload"]

print(data["status"], "blocked:", data["blocked"])
print("attempts:", data["attempts"], "rendered:", data["rendered"],
      "escalated:", data["escalated"], "clearance:", data.get("clearance"))
if data["blocked"]:
    print("block class:", data.get("blockClass"), "vendor:", data.get("vendor"))
html = data.get("body") or ""     # text form; bodyBase64 is always present too
Koperta odpowiedzi to { type, message, payload }. Wewnątrz payload otrzymujesz status (kod statusu pochodzenia), headers, body i bodyBase64, finalUrl, odcisk palca profile, attempts, rendered, escalated, blocked i, gdy coś zatrzymało żądanie, blockClass i vendor. Obiekt usage raportuje bajty obciążone za wywołanie.
Jedno zachowanie, które warto zaprojektować: domyślnie żądanie, które pozostało zablokowane po każdej próbie, nadal wraca z API jako HTTP 200, z blocked: true i stroną blokady w body do inspekcji. Jest oznaczone, a nie zamaskowane. Jeśli twój pipeline traktuje każde 200 jako sukces, ustaw failOnBlock: true i otrzymasz 502 z tymi samymi diagnostykami zamiast. Inne pola warte poznania: method i body dla POST, render: "html" aby rozpocząć w przeglądarce, waitForSelector, i returnCookies.

Zobacz, jak Web Unlocker obsługuje zablokowane żądania
Krok 4: odczytaj nagłówki x-qp i obsłuż zgłoszoną blokadę
Przez forward proxy, unlocker raportuje na samą odpowiedź. To są nagłówki warte logowania przy każdym wywołaniu:
| Nagłówek | Co ci mówi |
|---|---|
| x-qp-unlocker-attempts | Ile prób zajęło żądanie, włącznie z ponowieniami |
| x-qp-unlocker-rendered / x-qp-unlocker-escalated | Ustawione na 1, gdy bezgłowa przeglądarka pobrała stronę / gdy żądanie przeszło z poziomu TLS |
| x-qp-unlocker-profile | Który odcisk palca przeglądarki użyto w zwróconej próbie |
| x-qp-clearance | Co się stało z cachem zwolnienia przeglądarki przy tym wywołaniu: minted, hit lub miss |
| x-qp-session / x-qp-country | Sesja wyjściowa i kraj faktycznie użyty |
| x-qp-unlocker-blocked | Obecne tylko wtedy, gdy strona była nadal zablokowana po każdej próbie |
| x-qp-block-class / x-qp-vendor | Jaki rodzaj ściany to był i który dostawca anty-bota, gdy rozpoznany |
Strona, która jest nadal zablokowana, nigdy nie przychodzi jako ciche 200. Jeśli pochodzenie odmówiło z własnym błędem (403, 429, 503), ten status jest przekazywany bez zmian z ustawionym x-qp-unlocker-blocked. Jeśli pochodzenie serwowało stronę wyzwania z 2xx, proxy zamienia to na 502 i umieszcza kod pochodzenia w x-qp-origin-status. Więc jedno sprawdzenie obejmuje oba:
class Blocked(Exception):
    pass


s = requests.Session()
s.proxies = {"http": PROXY, "https": PROXY}
s.verify = False  # or "qp-unlocker-ca.pem"

NEXT_STEP = {
    "js_challenge":  "a browser could not clear it; retry later in a pinned session",
    "captcha":       "interactive captcha; not solved, decide in your own code",
    "ip_reputation": "the exit IP was refused; retry later, change country or test tier-mobile",
    "fingerprint":   "the client fingerprint was refused; retry with another profile",
    "geo":           "the content depends on location; set the country explicitly",
    "timeout":       "the target was too slow; raise x-qp-timeout or retry",
}


def unlock_get(url: str, session_id: str | None = None) -> requests.Response:
    headers = {"x-qp-session": session_id} if session_id else {}
    r = s.get(url, headers=headers, timeout=120)
    if "x-qp-unlocker-blocked" in r.headers:
        cls = r.headers.get("x-qp-block-class", "unknown")
        raise Blocked(
            f"{url}: HTTP {r.status_code}, class={cls}, "
            f"vendor={r.headers.get('x-qp-vendor')}, next: {NEXT_STEP.get(cls, 'inspect the body')}"
        )
    return r
Oto jak to wyglądało na stronach, które pozostały zablokowane w naszym biegu 29 września. Każda z nich wróciła z błędem statusu i klasą blokady, a nie stroną udającą treść:
| Strona | Status przez unlocker | x-qp-block-class | x-qp-vendor |
|---|---|---|---|
| Home Depot (strona kategorii) | 403 po 2 próbach | ip_reputation | akamai |
| eBay (wyszukiwanie) | 403 po 2 próbach | ip_reputation | akamai |
| DoorDash (strona miasta) | 403 po 2 próbach | ip_reputation | cloudflare |
| StockX (strona produktu) | 403, 'Just a moment...', po 2 próbach | js_challenge | cloudflare |
| Realtor.com (wyszukiwanie) | 429 po 2 próbach | fingerprint | kasada |
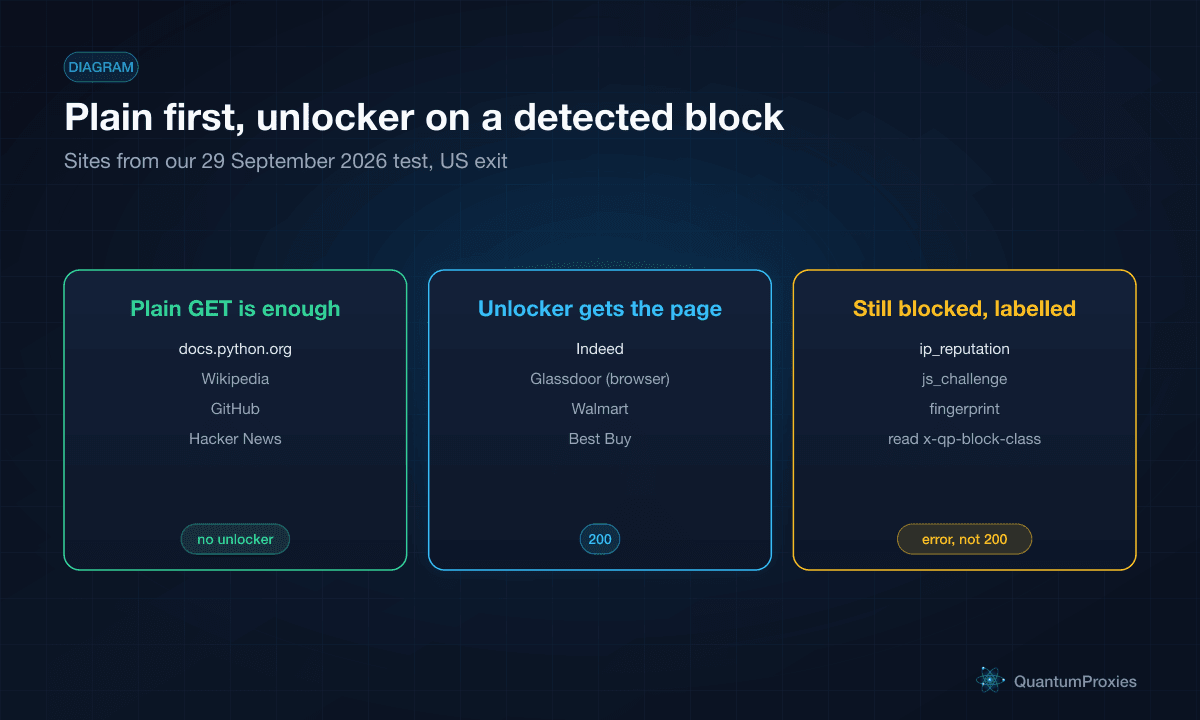
Te pięć to prawdziwe ograniczenia i twój kod powinien się ich spodziewać. Home Depot, eBay i DoorDash odmówiły wyjściowego IP, StockX nadal serwował stronę 'Just a moment...' Cloudflare, a Realtor.com odpowiedział 429 na odcisk palca. Klasa blokady mówi, która dźwignia może pomóc. Nie obiecuje, że jedna to zrobi.
Krok 5: wersja Node.js (api web unlocker w JavaScript)
W Node, fetch przyjmuje dispatcher. Użyj ProxyAgent z undici dla forward proxy i zaimportuj fetch z tego samego pakietu, aby obie wersje pasowały. Dokumentacja ProxyAgent wymienia opcje używane tutaj: token dla wartości Proxy-Authorization i requestTls dla ustawień TLS w kierunku celu.
// unlock.mjs  (npm i undici)
import { readFileSync } from "node:fs";
import { fetch, ProxyAgent } from "undici";

const user = process.env.QP_UNLOCK_USER + "-country-us";
const pass = process.env.QP_UNLOCK_PASSWORD;

const dispatcher = new ProxyAgent({
  uri: "http://unlock.quantumproxies.io:9000",
  token: "Basic " + Buffer.from(user + ":" + pass).toString("base64"),
  requestTls: { rejectUnauthorized: false },
  // verified instead: requestTls: { ca: readFileSync("qp-unlocker-ca.pem") },
});

const url = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX";
const res = await fetch(url, { dispatcher, headers: { "x-qp-session": "indeed-001" } });

if (res.headers.get("x-qp-unlocker-blocked")) {
  console.error("blocked:", res.status, res.headers.get("x-qp-block-class"), res.headers.get("x-qp-vendor"));
} else {
  const html = await res.text();
  console.log(res.status, res.headers.get("x-qp-unlocker-attempts"), html.length);
}
Punkt końcowy REST nie potrzebuje niczego poza fetch wbudowanym w Node 18+:
const resp = await fetch("https://app.quantumproxies.io/api/v1/scraper/unlock", {
  method: "POST",
  headers: {
    Authorization: "Bearer " + process.env.QP_API_KEY,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({ url: "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX", country: "us" }),
});
const { payload } = await resp.json();
console.log(payload.status, payload.blocked, payload.blockClass ?? "-", payload.attempts);
Na axios, zwykły wzorzec dla celów HTTPS za proxy to przekazanie agenta z https-proxy-agent jako httpsAgent i ustawienie proxy: false, lub wywołanie powyższego punktu końcowego REST i pominięcie całkowicie protokołu proxy.
Krok 6: kiedy nie potrzebujesz unlockera
Unlocker jest rozliczany za GB za każdy bajt, który przesuwa, w tym ponowienia i ładowania stron przeglądarki. Wysyłanie mu stron, które zwykłe żądanie pobiera dobrze, spala saldo na nic. W naszym biegu te wróciły dobrze bez żadnej pomocy:
| Strona | Zwykłe, serwer centrum danych | Zwykłe, proxy rezydencyjne | Web Unlocker |
|---|---|---|---|
| docs.python.org (strona urllib.request) | 200 | 200 | 200, 1,6 s |
| books.toscrape.com | 200 | 200 | 200, 1,9 s |
| news.ycombinator.com | 200 | 200 | 200, 4,1 s |
| en.wikipedia.org (Web scraping) | 200 | 200 | 200, 1,9 s |
| github.com (repozytorium scrapy) | 200 | 200 | 200, 2,0 s |
| bbc.com (Technologia) | 302 przekierowanie | 302 przekierowanie | 200, 1,4 s |
Wiersz BBC to nie blokada. Nasz testowy klient nie podążał za przekierowaniami, a 302 to strona wysyłająca cię do innego URL. requests domyślnie podąża za przekierowaniami i ląduje na stronie.
Więc właściwy wzorzec to najpierw zwykłe, unlocker na wykrytej blokadzie. Wykrywanie wymaga ostrożności. Skaner znaczników w naszym własnym narzędziu testowym oznaczył strony Wikipedia i GitHub jako zablokowane, ponieważ ich ciała zawierają słowo 'captcha', mimo że obie zwróciły rzeczywistą stronę z 200. Sprawdź kod statusu, nagłówek cf-mitigated Cloudflare i tytuł strony, a nie całe ciało:
from urllib.parse import urlsplit

BLOCK_STATUSES = {403, 429, 503}
BLOCK_TITLES = (
    "just a moment",                        # Cloudflare challenge
    "attention required",                   # Cloudflare block page
    "access denied",                        # Akamai and others
    "security check",
    "access to this page has been denied",  # PerimeterX
)
needs_unlocker: set[str] = set()            # domains that blocked plain requests


def looks_blocked(r: requests.Response) -> bool:
    if r.status_code in BLOCK_STATUSES:
        return True
    if r.headers.get("cf-mitigated") == "challenge":
        return True
    return any(t in title_of(r.text).lower() for t in BLOCK_TITLES)


def fetch(url: str, session_id: str | None = None) -> tuple[requests.Response, str]:
    host = urlsplit(url).hostname or ""
    if host not in needs_unlocker:
        try:
            r = requests.get(url, headers=HEADERS, timeout=20)
            if not looks_blocked(r):
                return r, "plain"
        except requests.RequestException:
            pass  # a reset or a timeout counts as a block too
        needs_unlocker.add(host)
    return unlock_get(url, session_id), "unlocker"   # from step 4; raises Blocked


for u in ("https://docs.python.org/3/library/urllib.request.html", URL):
    resp, route = fetch(u)
    print(route, resp.status_code, title_of(resp.text)[:60])
Gałąź except ma znaczenie. Kategoria laptopów Best Buy nigdy nie dała naszym zwykłym klientom odpowiedzi HTTP: połączenie nie powiodło się zarówno z serwera centrum danych, jak i przez proxy rezydencyjne. Przez unlocker ten sam URL zwrócił 200 przy pierwszej próbie w 6,3 sekundy. Skrypt, który sprawdza tylko kody statusu, nigdy by tego nie eskalował.
Zmierzone wyniki: cztery strony, które potrzebowały unlockera
Zmierzono 29 września 2026. Zwykłe żądania były curl z User-Agent Chrome, raz z serwera centrum danych we Frankfurcie i raz przez proxy rezydencyjne z wyjściem w USA. Żądania Web Unlocker używały poziomu rezydencyjnego z wyjściem w USA. Czas to zegar ścienny dla pojedynczego żądania.
| Strona | Zwykłe, serwer centrum danych | Zwykłe, proxy rezydencyjne | Web Unlocker |
|---|---|---|---|
| Indeed (wyszukiwanie pracy) | 403, strona 'Security Check' | 403, 'Enable JavaScript and cookies to continue' | 200, 1 próba, 2,6 s |
| Glassdoor (recenzje firm) | 403, strona 'Security' z captcha | 403, 'Enable JavaScript and cookies to continue' | 200, 2 próby + przeglądarka, 17,2 s |
| Walmart (wyszukiwanie) | 307 przekierowanie, brak strony wyników | 307 przekierowanie, brak strony wyników | 200, 1 próba, 4,8 s |
| Best Buy (kategoria laptopów) | Połączenie nieudane, brak odpowiedzi | Połączenie nieudane, brak odpowiedzi | 200, 1 próba, 6,3 s |
Krótko mówiąc: Indeed, Walmart i Best Buy przeszły przy pierwszej próbie TLS bez przeglądarki. Glassdoor potrzebował pełnej ścieżki, dwóch prób TLS, a następnie bezgłowej przeglądarki, aby odpowiedzieć na wyzwanie JavaScript, co zajęło 17,2 sekundy. Dla Walmart nie zapisaliśmy, gdzie skierował 307. Co możemy powiedzieć, to że żaden zwykły klient nie otrzymał strony wyników, a unlocker tak.
Powtarzające się żądania do strony chronionej wyzwaniem stają się szybsze, gdy przypinasz sesję. Wyślij tę samą wartość nagłówka x-qp-session, lub zachowaj ten sam -session-<id> w nazwie użytkownika proxy, a ciasteczko zwolnienia zdobyte przez przeglądarkę jest ponownie używane. W teście Glassdoor 29 września 2026, z przypiętą sesją w nazwie użytkownika i dwoma oddzielnymi połączeniami, pierwsze żądanie zajęło 14,0 sekundy przez przeglądarkę, a drugie 1,4 sekundy, z x-qp-clearance: hit. Nasz przewodnik po skrobaniu ogłoszeń o pracę Indeed obejmuje, co zrobić ze stroną, gdy już ją masz.
Ograniczenia warte poznania przed budowaniem na nim
- Interaktywne captchy nie są rozwiązywane. Suwak, przytrzymaj lub siatka obrazów powoduje, że żądanie kończy się niepowodzeniem, zamiast wracać jako 200; punkt końcowy REST raportuje to z klasą blokady
captcha. Co dzieje się dalej, zależy od twojego kodu. - POST jest wysyłany raz. GET, HEAD i OPTIONS ponawiają na nowym IP pod innym odciskiem palca. POST i inne metody nieidempotentne mają dokładnie jedną próbę, ponieważ powtórzenie jednej mogłoby dwukrotnie przesłać formularz lub zamówienie.
- Każdy bajt się liczy. Ponowienia, zablokowane strony i ładowanie strony przeglądarki są wszystkie obciążane z przedpłaconego GB poziomu. Gdy saldo się wyczerpie, proxy odpowiada 402.
- Trudne cele zajmują czas. Próby TLS działają w budżecie 90 sekund, a eskalacja przeglądarki dodaje ładowanie strony na wierzchu. Ustaw limit czasu klienta powyżej tego (przykłady używają 120 sekund) zamiast zwykłych 10.
- Niektóre strony pozostają zablokowane. Pięć w tabeli powyżej tak zrobiło. Czy możesz zbierać dane z danej strony zależy od jej warunków i twojej jurysdykcji; to nie jest porada prawna.
Jeśli dotarłeś tutaj z 403, które występuje tylko poza przeglądarką, nasz wyjaśniacz na dlaczego curl dostaje 403, gdy przeglądarka działa idzie głębiej w diagnozę. Dla spojrzenia na stronę po stronie, której warstwy faktycznie potrzebujesz, zobacz web unlocker vs residential proxy, przetestowane.
Często zadawane pytania
Czy istnieje darmowe API web unlocker?
Otwarte komponenty są darmowe: requests, curl_cffi dla TLS podobnego do przeglądarki i Playwright dla prawdziwej przeglądarki. Dobrze je uruchomić to praca, ponieważ potrzebujesz również czystych wyjściowych IP i przeglądarki dla wyzwań JavaScript. Na QuantumProxies.io, założenie konta jest darmowe, a ruch unlockera jest rozliczany za GB z przedpłaconego salda, które doładowujesz w panelu.
Czy można skrobać Glassdoor lub Zillow za pomocą Python?
W naszym teście 29 września 2026, zwykłe żądania do strony recenzji Glassdoor otrzymały 403 zarówno z serwera centrum danych, jak i przez proxy rezydencyjne, a unlocker zwrócił stronę po eskalacji przeglądarki. Zillow zablokował serwer centrum danych, ale obsłużył stronę przez zwykłe proxy rezydencyjne. Sprawdź warunki każdej strony, zanim cokolwiek zbierzesz.
Czy skrobanie stron może być wykryte?
Tak. Strony oceniają typ sieci i historię IP, handshake TLS, ustawienia HTTP/2, kolejność nagłówków i, na stronach wyzwań, co JavaScript raportuje o przeglądarce. Zwykłe żądanie Python nie spełnia kilku z nich naraz. Dlatego zmiana tylko User-Agent rzadko pomaga, i dlatego unlocker zmienia IP, odcisk palca i, gdy to konieczne, cały klient.
Czy muszę zainstalować certyfikat, aby używać forward proxy?
Tylko dla HTTPS przez klasyczne forward proxy, ponieważ unlocker kończy TLS, aby przepisać żądanie. Albo pomiń weryfikację dla tej sesji (verify=False w Python, -k w curl) albo pobierz CA z /api/v1/scraper/unlock/ca z kluczem API i zaufaj mu. Punkt końcowy REST nie potrzebuje żadnego certyfikatu.
Czy web unlocker rozwiązuje captchy?
Odpowiada na wyzwania JavaScript za pomocą prawdziwej bezgłowej przeglądarki i może ponownie użyć ciasteczka zwolnienia w przypiętej sesji. Nie rozwiązuje interaktywnych captchy, takich jak suwaki, przytrzymaj lub siatki obrazów. Te żądania kończą się niepowodzeniem zamiast zwracać stronę captcha jako 200. Na punkcie końcowym REST są oznaczone klasą blokady captcha, plus dostawca, gdy jest rozpoznany, więc twój kod może zdecydować, co zrobić dalej.
Jak utrzymać to samo IP przez kilka żądań?
Wyślij tę samą wartość nagłówka x-qp-session przy każdym żądaniu przez forward proxy, lub umieść ten sam -session-<id> w nazwie użytkownika proxy. Wywołania dzielące tę sesję wychodzą z tego samego wyjścia, a ciasteczko zwolnienia zdobyte przez przeglądarkę jest ponownie używane. Na punkcie końcowym REST, przekaż sessionId z rotacją ustawioną na sticky. Sticky session może trwać od 3 do 1 440 minut.
Cały wzorzec mieści się w jednym zdaniu: pobierz zwyczajnie, wykryj blokadę przez status, nagłówek i tytuł, wyślij tylko te URL przez unlocker i loguj nagłówki x-qp, aby wiedzieć, ile każda strona cię kosztowała. Zacznij od poziomu rezydencyjnego, a poziom mobilny zachowaj dla celów, które odmawiają również zakresów rezydencyjnych.