Tutorial API Web Unlocker: Python e Node.js, Bloccato vs Sbloccato
Codice funzionante in Python e Node.js per un'API web unlocker: la stessa richiesta contro un sito che blocca i client semplici e uno che non lo fa, come leggere ciò che riporta l'unlocker e un helper che paga l'unlocker solo quando viene rilevato un blocco.
Un'API web unlocker riproduce una richiesta HTTP da un IP residenziale sotto un fingerprint TLS del browser, riprovando con un nuovo IP e passando a un browser reale quando il sito risponde con una sfida. Questo tutorial API web unlocker lo mostra in Python e Node.js, su un sito che blocca i client semplici e uno che non lo fa.
Ogni risultato citato di seguito è stato misurato il 29 settembre 2026: lo stesso URL recuperato con curl semplice da un server datacenter a Francoforte, con curl semplice attraverso un proxy residenziale con uscita negli Stati Uniti, e attraverso il Web Unlocker di QuantumProxies.io con uscita negli Stati Uniti. Dove un sito non ha bisogno dell'unlocker, lo diciamo, perché la richiesta più economica è quella che funziona senza di esso.
- Due modi per accedere: un proxy forward su
unlock.quantumproxies.io:9000per il codice che già parla il protocollo proxy, oPOST /api/v1/scraper/unlockcon la tua chiave API per tutto il resto. - Cosa ottieni indietro: lo stato, gli header e il corpo dell'origine, più gli header
x-qp-*che indicano quanti tentativi ci sono voluti, se è stato eseguito un browser e quale tipo di muro lo ha fermato se c'è stato. - Quando non ne hai bisogno: Wikipedia, GitHub, docs.python.org, Hacker News e books.toscrape.com hanno tutti risposto a richieste semplici nel nostro test. Prova prima con la richiesta semplice ed esegui l'upgrade solo su un blocco rilevato.
Cosa ti serve prima di iniziare
- Un account QuantumProxies.io con larghezza di banda Web Unlocker. L'unlocker addebita da un saldo GB prepagato, separato per il livello residenziale e il livello mobile (uscite carrier 4G/5G).
- Per il proxy forward: un sub-utente proxy creato sulla pagina Web Unlocker del dashboard. Assomiglia a
unlock-XXXXXXXXcon la sua password. Non è la tua chiave API. - Per l'endpoint REST: una chiave API dal dashboard, inviata come
Authorization: Bearer. - Python 3.10 o più recente con
requests, e per la parte Node.js Node 18 o più recente con il pacchettoundici.
Tieni entrambi i segreti nelle variabili d'ambiente. Gli esempi leggono QP_UNLOCK_USER, QP_UNLOCK_PASSWORD e QP_API_KEY. Se la password del proxy contiene caratteri come @ o :, codificala in URL con urllib.parse.quote prima di inserirla in un URL del proxy.
Passo 1: vedere il blocco con richieste Python semplici
Inizia con il fallimento, così sai cosa stai correggendo. L'obiettivo è una ricerca di lavoro su Indeed. Dal nostro server datacenter a Francoforte ha risposto con 403 con una pagina intitolata 'Security Check - Indeed.com'. Attraverso un proxy residenziale semplice ha ancora risposto con 403, questa volta con un corpo che chiedeva al client di 'Enable JavaScript and cookies to continue'. Un IP domestico pulito non era sufficiente.
import re
import requests

URL = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX"
HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/150.0.0.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}


def title_of(html: str) -> str:
    m = re.search(r"<title[^>]*>(.*?)</title>", html, re.I | re.S)
    return m.group(1).strip() if m else ""


r = requests.get(URL, headers=HEADERS, timeout=30)
print(r.status_code, "|", title_of(r.text))
# Our datacenter run on 29 Sep 2026 saw: 403 | Security Check - Indeed.com
La nostra misurazione ha utilizzato curl con un User-Agent di Chrome, non requests, e non c'è motivo di aspettarsi che requests se la cavi meglio. Una stringa User-Agent è un header. Il livello anti-bot legge anche la stretta di mano TLS e le impostazioni HTTP/2, e quelle dicono ancora Python qualunque User-Agent tu imposti. Ecco perché cambiare gli header raramente ti fa superare il rilevamento bot in Python requests; il lato della stretta di mano è coperto nella nostra guida a fingerprinting TLS e perché gli IP puliti vengono ancora bloccati. Un 403 significa che il server ha compreso la richiesta e l'ha rifiutata (RFC 9110, sezione 15.5.4). Non significa che il tuo URL o i tuoi parametri siano sbagliati.
Passo 2: la stessa chiamata attraverso il proxy forward
Il proxy forward è il cambiamento più piccolo al codice esistente: passalo come proxy e nient'altro si muove. Il targeting viaggia nel nome utente. -country-us sceglie il paese di uscita, -tier-mobile passa alle uscite mobili, e -profile-firefox (o chrome, safari, safariios, edge, brave, mobile) fissa un fingerprint TLS invece di lasciare che i tentativi lo ruotino.
import os
import requests
import urllib3

urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

user = os.environ["QP_UNLOCK_USER"] + "-country-us"   # e.g. unlock-XXXXXXXX-country-us
password = os.environ["QP_UNLOCK_PASSWORD"]
PROXY = f"http://{user}:{password}@unlock.quantumproxies.io:9000"

r = requests.get(
    URL,
    headers=HEADERS,
    proxies={"http": PROXY, "https": PROXY},
    verify=False,   # or verify="qp-unlocker-ca.pem", see below
    timeout=120,
)
print(r.status_code, "|", title_of(r.text))
print("attempts:", r.headers.get("x-qp-unlocker-attempts"),
      "rendered:", r.headers.get("x-qp-unlocker-rendered"))
Il 29 settembre questo ha restituito 200 con la vera pagina dei risultati, intitolata 'Now Hiring: 2,000 Data Engineer Jobs in Austin, TX | Indeed', al primo tentativo TLS, in 2,6 secondi, senza avviare un browser.
Perché verify=False? Per riscrivere una richiesta HTTPS, l'unlocker deve terminare il TLS del tuo client e presentare il proprio certificato per l'host di destinazione. Hai due opzioni pulite. Disattiva la verifica solo per questa sessione, come sopra, che è ciò che fa curl -k. Oppure scarica una volta il CA dell'unlocker e fidati esplicitamente, così la verifica rimane attiva:
curl -H "Authorization: Bearer $QP_API_KEY" \
  -o qp-unlocker-ca.pem https://app.quantumproxies.io/api/v1/scraper/unlock/ca
Quindi passa verify="qp-unlocker-ca.pem" invece di False. I documenti di utilizzo avanzato di requests coprono sia l'argomento proxies che i bundle CA personalizzati. Se non vuoi nessuno dei due, l'endpoint REST qui sotto non ha bisogno di alcun certificato.
Passo 3: l'endpoint REST, nessun protocollo proxy
L'endpoint REST esegue lo stesso motore dietro una normale chiamata HTTPS. Descrivi la richiesta che avresti fatto (url, metodo, header, corpo) e ottieni la risposta dell'origine indietro come JSON. L'unico campo richiesto è url.
import os
import requests

API_KEY = os.environ["QP_API_KEY"]

resp = requests.post(
    "https://app.quantumproxies.io/api/v1/scraper/unlock",
    headers={"Authorization": f"Bearer {API_KEY}"},
    json={
        "url": URL,
        "country": "us",
        # "tier": "mobile",        # mobile exits, billed on the mobile balance
        # "failOnBlock": True,     # HTTP 502 instead of 200 when every tier was blocked
    },
    timeout=130,
)
resp.raise_for_status()           # 402 = no unlocker GB left, 400 = bad input
data = resp.json()["payload"]

print(data["status"], "blocked:", data["blocked"])
print("attempts:", data["attempts"], "rendered:", data["rendered"],
      "escalated:", data["escalated"], "clearance:", data.get("clearance"))
if data["blocked"]:
    print("block class:", data.get("blockClass"), "vendor:", data.get("vendor"))
html = data.get("body") or ""     # text form; bodyBase64 is always present too
L'involucro della risposta è { type, message, payload }. All'interno di payload ottieni status (il codice di stato dell'origine), headers, body e bodyBase64, finalUrl, il fingerprint profile, attempts, rendered, escalated, blocked e, quando qualcosa ha fermato la richiesta, blockClass e vendor. Un oggetto usage riporta i byte addebitati per la chiamata.
Un comportamento su cui progettare: per impostazione predefinita, una richiesta che è rimasta bloccata dopo ogni tentativo torna comunque dall'API come HTTP 200, con blocked: true e la pagina di blocco in body per l'ispezione. È etichettata, non mascherata. Se la tua pipeline tratta qualsiasi 200 come successo, imposta failOnBlock: true e ottieni un 502 che trasporta gli stessi diagnostici invece. Altri campi che vale la pena conoscere: method e body per i POST, render: "html" per iniziare in un browser, waitForSelector e returnCookies.
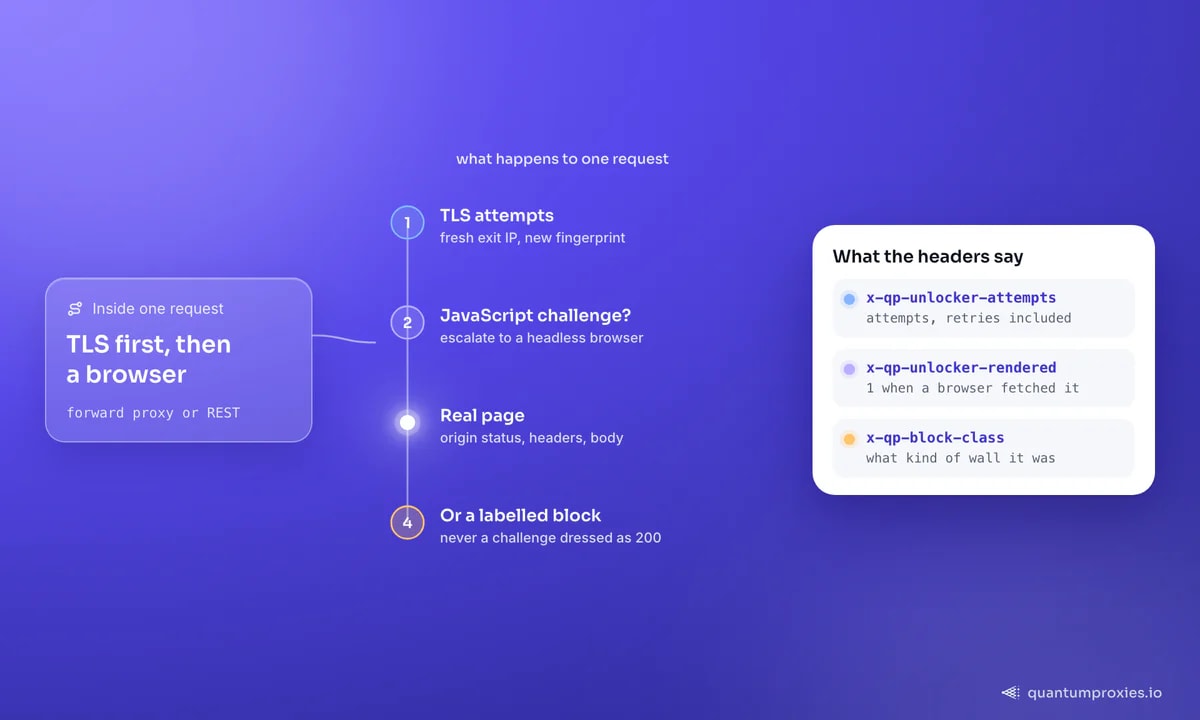
Vedi come il Web Unlocker gestisce le richieste bloccate
Passo 4: leggi gli header x-qp e gestisci un blocco segnalato
Attraverso il proxy forward, l'unlocker riporta sulla risposta stessa. Questi sono gli header che vale la pena registrare su ogni chiamata:
| Header | Cosa ti dice |
|---|---|
| x-qp-unlocker-attempts | Quanti tentativi ha richiesto la richiesta, inclusi i retry |
| x-qp-unlocker-rendered / x-qp-unlocker-escalated | Impostato a 1 quando un browser headless ha recuperato la pagina / quando la richiesta è passata dal livello TLS |
| x-qp-unlocker-profile | Quale fingerprint del browser ha utilizzato il tentativo restituito |
| x-qp-clearance | Cosa è successo con la cache di autorizzazione del browser in questa chiamata: minted, hit o miss |
| x-qp-session / x-qp-country | La sessione di uscita e il paese effettivamente utilizzati |
| x-qp-unlocker-blocked | Presente solo quando la pagina è ancora bloccata dopo ogni tentativo |
| x-qp-block-class / x-qp-vendor | Che tipo di muro era, e quale fornitore anti-bot, quando riconosciuto |
Una pagina che è ancora bloccata non arriva mai come un silenzioso 200. Se l'origine ha rifiutato con il proprio errore (403, 429, 503), quello stato viene trasmesso invariato con x-qp-unlocker-blocked impostato. Se l'origine ha servito una pagina di sfida con un 2xx, il proxy la trasforma in un 502 e mette il codice dell'origine in x-qp-origin-status. Quindi un controllo copre entrambi:
class Blocked(Exception):
    pass


s = requests.Session()
s.proxies = {"http": PROXY, "https": PROXY}
s.verify = False  # or "qp-unlocker-ca.pem"

NEXT_STEP = {
    "js_challenge":  "a browser could not clear it; retry later in a pinned session",
    "captcha":       "interactive captcha; decide in your own code",
    "access_denied": "the site denied access; retry with a fresh session or test tier-mobile",
    "rate_limited":  "the site is rate limiting; slow down and retry later",
    "fingerprint":   "the client fingerprint was refused; retry with another profile",
    "geo":           "the content depends on location; set the country explicitly",
    "timeout":       "the target was too slow; raise x-qp-timeout or retry",
}


def unlock_get(url: str, session_id: str | None = None) -> requests.Response:
    headers = {"x-qp-session": session_id} if session_id else {}
    r = s.get(url, headers=headers, timeout=120)
    if "x-qp-unlocker-blocked" in r.headers:
        cls = r.headers.get("x-qp-block-class", "unknown")
        raise Blocked(
            f"{url}: HTTP {r.status_code}, class={cls}, "
            f"vendor={r.headers.get('x-qp-vendor')}, next: {NEXT_STEP.get(cls, 'inspect the body')}"
        )
    return r
Passo 5: la versione Node.js (API web unlocker in JavaScript)
In Node, fetch prende un dispatcher. Usa ProxyAgent da undici per il proxy forward, e importa fetch dallo stesso pacchetto in modo che le due versioni corrispondano. La documentazione di ProxyAgent elenca le opzioni utilizzate qui: token per il valore di Proxy-Authorization e requestTls per le impostazioni TLS verso il target.
// unlock.mjs  (npm i undici)
import { readFileSync } from "node:fs";
import { fetch, ProxyAgent } from "undici";

const user = process.env.QP_UNLOCK_USER + "-country-us";
const pass = process.env.QP_UNLOCK_PASSWORD;

const dispatcher = new ProxyAgent({
  uri: "http://unlock.quantumproxies.io:9000",
  token: "Basic " + Buffer.from(user + ":" + pass).toString("base64"),
  requestTls: { rejectUnauthorized: false },
  // verified instead: requestTls: { ca: readFileSync("qp-unlocker-ca.pem") },
});

const url = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX";
const res = await fetch(url, { dispatcher, headers: { "x-qp-session": "indeed-001" } });

if (res.headers.get("x-qp-unlocker-blocked")) {
  console.error("blocked:", res.status, res.headers.get("x-qp-block-class"), res.headers.get("x-qp-vendor"));
} else {
  const html = await res.text();
  console.log(res.status, res.headers.get("x-qp-unlocker-attempts"), html.length);
}
L'endpoint REST non ha bisogno di nulla oltre al fetch integrato in Node 18+:
const resp = await fetch("https://app.quantumproxies.io/api/v1/scraper/unlock", {
  method: "POST",
  headers: {
    Authorization: "Bearer " + process.env.QP_API_KEY,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({ url: "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX", country: "us" }),
});
const { payload } = await resp.json();
console.log(payload.status, payload.blocked, payload.blockClass ?? "-", payload.attempts);
Su axios, il solito schema per i target HTTPS dietro un proxy è passare un agente da https-proxy-agent come httpsAgent e impostare proxy: false, o chiamare l'endpoint REST sopra e saltare completamente il protocollo proxy.
Passo 6: quando non hai bisogno dell'unlocker
L'unlocker viene addebitato per GB su ogni byte che sposta, inclusi retry e caricamenti di pagine del browser. Inviare pagine che una richiesta semplice recupera bene brucia il saldo per niente. Nella nostra esecuzione, questi sono tornati bene senza alcun aiuto:
| Sito | Semplice, server datacenter | Semplice, proxy residenziale | Web Unlocker |
|---|---|---|---|
| docs.python.org (pagina urllib.request) | 200 | 200 | 200, 1,6 s |
| books.toscrape.com | 200 | 200 | 200, 1,9 s |
| news.ycombinator.com | 200 | 200 | 200, 4,1 s |
| en.wikipedia.org (Web scraping) | 200 | 200 | 200, 1,9 s |
| github.com (repository scrapy) | 200 | 200 | 200, 2,0 s |
| bbc.com (Tecnologia) | 302 redirect | 302 redirect | 200, 1,4 s |
La riga della BBC non è un blocco. Il nostro client di test non ha seguito i redirect, e il 302 è il sito che ti invia a un altro URL. requests segue i redirect per impostazione predefinita e atterra sulla pagina.
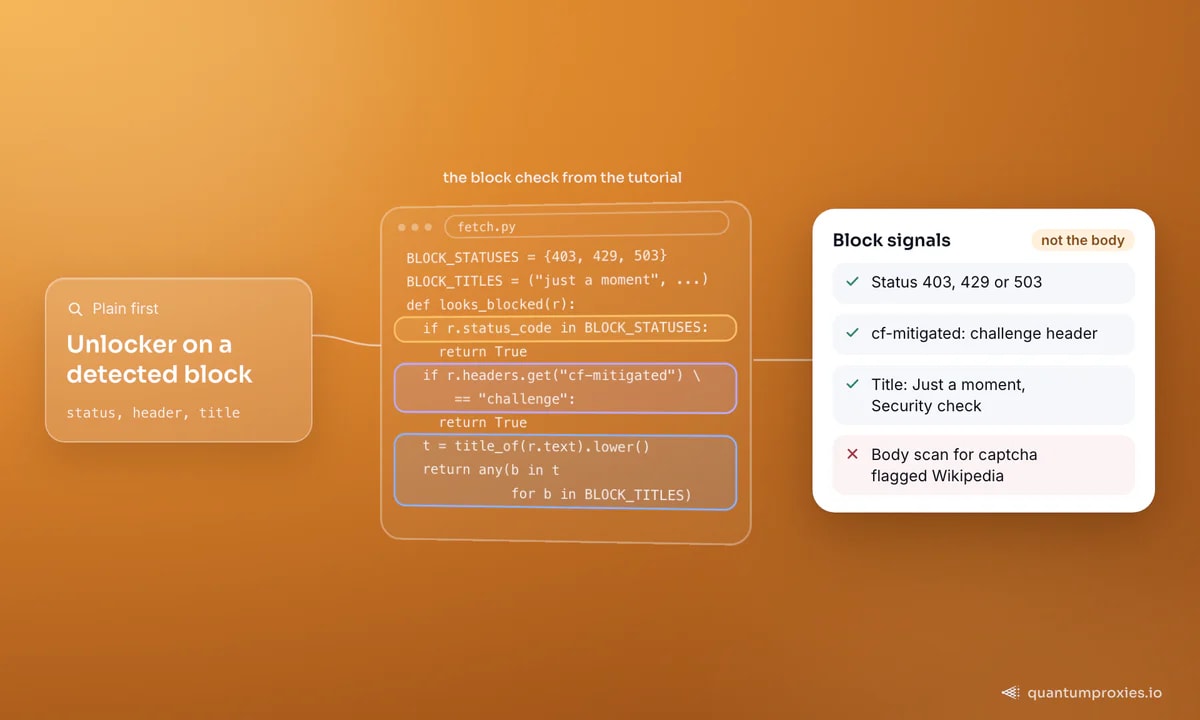
Quindi il giusto schema è semplice prima, unlocker su un blocco rilevato. La rilevazione richiede attenzione. La scansione dei marker nel nostro stesso test ha segnalato le pagine di Wikipedia e GitHub come bloccate perché i loro corpi contengono la parola 'captcha', anche se entrambi hanno restituito la vera pagina con un 200. Controlla il codice di stato, l'header cf-mitigated di Cloudflare e il titolo della pagina, non l'intero corpo:
from urllib.parse import urlsplit

BLOCK_STATUSES = {403, 429, 503}
BLOCK_TITLES = (
    "just a moment",                        # Cloudflare challenge
    "attention required",                   # Cloudflare block page
    "access denied",                        # Akamai and others
    "security check",
    "access to this page has been denied",  # PerimeterX
)
needs_unlocker: set[str] = set()            # domains that blocked plain requests


def looks_blocked(r: requests.Response) -> bool:
    if r.status_code in BLOCK_STATUSES:
        return True
    if r.headers.get("cf-mitigated") == "challenge":
        return True
    return any(t in title_of(r.text).lower() for t in BLOCK_TITLES)


def fetch(url: str, session_id: str | None = None) -> tuple[requests.Response, str]:
    host = urlsplit(url).hostname or ""
    if host not in needs_unlocker:
        try:
            r = requests.get(url, headers=HEADERS, timeout=20)
            if not looks_blocked(r):
                return r, "plain"
        except requests.RequestException:
            pass  # a reset or a timeout counts as a block too
        needs_unlocker.add(host)
    return unlock_get(url, session_id), "unlocker"   # from step 4; raises Blocked


for u in ("https://docs.python.org/3/library/urllib.request.html", URL):
    resp, route = fetch(u)
    print(route, resp.status_code, title_of(resp.text)[:60])
Il ramo except è importante. La categoria laptop di Best Buy non ha mai dato ai nostri client semplici una risposta HTTP: la connessione è fallita sia dal server datacenter che dal proxy residenziale. Attraverso l'unlocker lo stesso URL ha restituito 200 al primo tentativo in 6,3 secondi. Uno scraper che controlla solo i codici di stato non avrebbe mai eseguito l'upgrade di quello.
Risultati misurati: quattro siti che hanno avuto bisogno dell'unlocker
Misurato il 29 settembre 2026. Le richieste semplici erano curl con un User-Agent di Chrome, una volta da un server datacenter a Francoforte e una volta attraverso un proxy residenziale con uscita negli Stati Uniti. Le richieste Web Unlocker hanno utilizzato il livello residenziale con uscita negli Stati Uniti. I tempi sono a orologio per una singola richiesta.
| Sito | Semplice, server datacenter | Semplice, proxy residenziale | Web Unlocker |
|---|---|---|---|
| Indeed (ricerca lavoro) | 403, pagina 'Security Check' | 403, 'Enable JavaScript and cookies to continue' | 200, 1 tentativo, 2,6 s |
| Glassdoor (recensioni aziendali) | 403, pagina 'Security' con captcha | 403, 'Enable JavaScript and cookies to continue' | 200, 2 tentativi + browser, 17,2 s |
| Walmart (ricerca) | 307 redirect, nessuna pagina risultati | 307 redirect, nessuna pagina risultati | 200, 1 tentativo, 4,8 s |
| Best Buy (categoria laptop) | Connessione fallita, nessuna risposta | Connessione fallita, nessuna risposta | 200, 1 tentativo, 6,3 s |
In breve: Indeed, Walmart e Best Buy sono passati al primo tentativo TLS senza browser. Glassdoor ha avuto bisogno del percorso completo, due tentativi TLS e poi un browser headless per rispondere alla sfida JavaScript, motivo per cui ci sono voluti 17,2 secondi. Per Walmart non abbiamo registrato dove puntava il 307. Quello che possiamo dire è che nessun client semplice ha ricevuto la pagina dei risultati e l'unlocker sì.
Le richieste ripetute a un sito protetto da sfide diventano più veloci quando si fissa una sessione. Invia lo stesso valore dell'header x-qp-session, o mantieni lo stesso -session-<id> nel nome utente del proxy, e il cookie di autorizzazione guadagnato dal browser viene riutilizzato. In un test su Glassdoor il 29 settembre 2026, con la sessione fissata nel nome utente e due connessioni separate, la prima richiesta ha impiegato 14,0 secondi attraverso il browser e la seconda 1,4 secondi, con x-qp-clearance: hit. La nostra guida allo scraping delle offerte di lavoro su Indeed copre cosa fare con la pagina una volta che l'hai ottenuta.
Se sei arrivato qui da un 403 che si verifica solo al di fuori del browser, il nostro spiegatore su perché curl ottiene un 403 quando il browser funziona va più a fondo nella diagnosi. Per uno sguardo sito per sito a quale livello hai effettivamente bisogno, vedi web unlocker vs residential proxy, testato.
Domande frequenti
Esiste un'API web unlocker gratuita?
I pezzi open-source sono gratuiti: requests, curl_cffi per TLS simile al browser e Playwright per un browser reale. Farli funzionare bene è il lavoro, perché hai anche bisogno di IP di uscita puliti e di un browser per le sfide JavaScript. Su QuantumProxies.io, creare un account è gratuito, e il traffico dell'unlocker è addebitato per GB da un saldo prepagato che ricarichi nel dashboard.
Puoi fare scraping su Glassdoor o Zillow con Python?
Nel nostro test del 29 settembre 2026, le richieste semplici a una pagina di recensioni di Glassdoor hanno ottenuto un 403 sia da un server datacenter che da un proxy residenziale, e l'unlocker ha restituito la pagina dopo un'escalation del browser. Zillow ha bloccato il server datacenter ma ha servito la pagina attraverso un proxy residenziale semplice. Controlla i termini di ciascun sito prima di raccogliere qualsiasi cosa.
Lo scraping web può essere rilevato?
Sì. I siti valutano il tipo di rete e la storia dell'IP, la stretta di mano TLS, le impostazioni HTTP/2, l'ordine degli header e, sulle pagine di sfida, ciò che JavaScript riporta sul browser. Una richiesta Python semplice fallisce in diversi di questi contemporaneamente. Ecco perché cambiare solo l'User-Agent raramente aiuta, e perché l'unlocker cambia l'IP, il fingerprint e, quando necessario, l'intero client.
Devo installare un certificato per usare il proxy forward?
Solo per HTTPS attraverso il classico proxy forward, perché l'unlocker termina TLS per riscrivere la richiesta. Puoi saltare la verifica per quella sessione (verify=False in Python, -k in curl) o scaricare il CA da /api/v1/scraper/unlock/ca con la tua chiave API e fidarti di esso. L'endpoint REST non ha bisogno di alcun certificato.
Come mantengo lo stesso IP su più richieste?
Invia lo stesso valore dell'header x-qp-session su ogni richiesta attraverso il proxy forward, o metti lo stesso -session-<id> nel nome utente del proxy. Le chiamate che condividono quella sessione partono dalla stessa uscita, e un cookie di autorizzazione guadagnato dal browser viene riutilizzato. Sull'endpoint REST, passa un sessionId con rotazione impostata su sticky. Una sessione sticky può durare da 3 a 1.440 minuti.
L'intero schema si adatta in una frase: recupera semplicemente, rileva un blocco per stato, header e titolo, invia solo quegli URL attraverso l'unlocker e registra gli header x-qp così sai quanto ti è costata ogni pagina. Inizia con il livello residenziale e tieni il livello Mobile per i target che rifiutano anche le gamme residenziali.