Tutoriel API Web Unlocker : Python et Node.js, Bloqué vs Débloqué
Code fonctionnel en Python et Node.js pour une API de web unlocker : la même requête contre un site qui bloque les clients simples et un qui ne le fait pas, comment lire les rapports de l'unlocker, et un assistant qui ne paie pour l'unlocker que lorsqu'un blocage est détecté.
Une API de web unlocker rejoue une requête HTTP à partir d'une IP résidentielle sous une empreinte TLS de navigateur, réessayant avec une nouvelle IP et passant à un vrai navigateur lorsque le site répond avec un défi. Ce tutoriel d'API de web unlocker le montre en Python et Node.js, sur un site qui bloque les clients simples et un qui ne le fait pas.
Chaque résultat cité ci-dessous a été mesuré le 29 septembre 2026 : la même URL récupérée avec curl simple depuis un serveur de datacenter à Francfort, avec curl simple via un proxy résidentiel avec une sortie aux États-Unis, et via le Web Unlocker de QuantumProxies.io avec une sortie aux États-Unis. Là où un site n'avait pas besoin de l'unlocker, nous le disons, car la requête la moins chère est celle qui fonctionne sans.
- Deux façons d'entrer : un proxy de transfert à
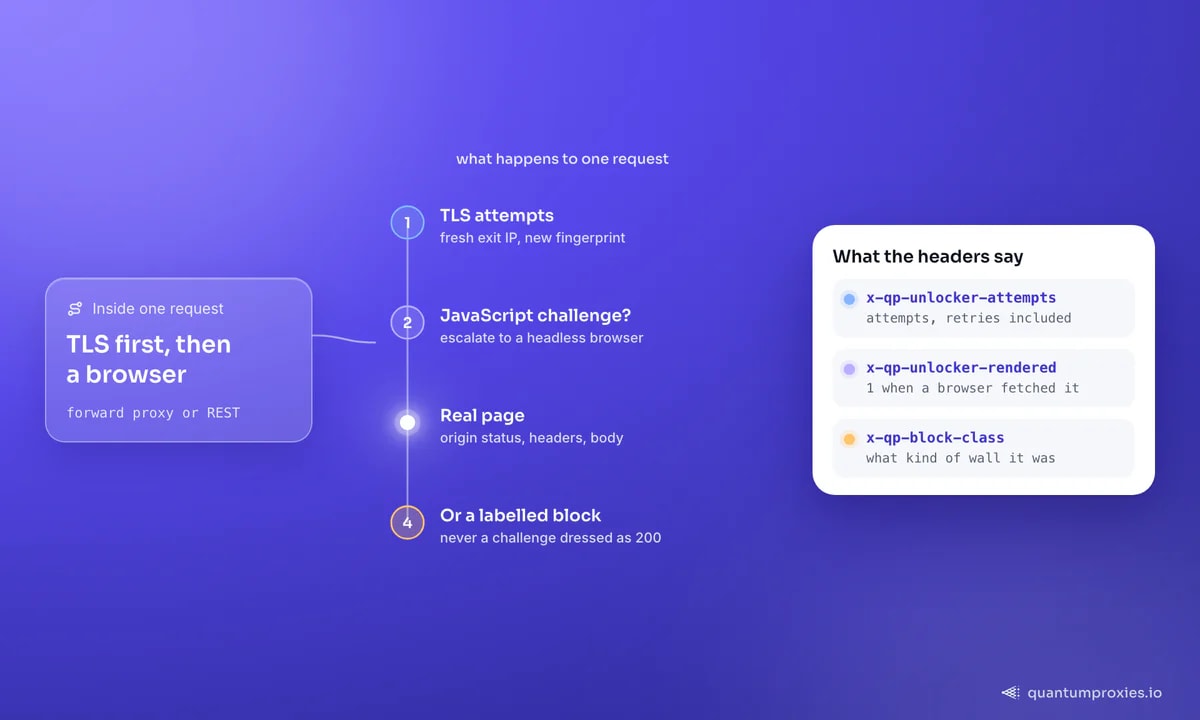
unlock.quantumproxies.io:9000pour le code qui parle déjà le protocole proxy, ouPOST /api/v1/scraper/unlockavec votre clé API pour tout le reste. - Ce que vous obtenez en retour : le statut, les en-têtes et le corps de l'origine, plus les en-têtes
x-qp-*indiquant combien de tentatives ont été nécessaires, si un navigateur a été utilisé, et quel type de mur l'a arrêté si c'était le cas. - Quand vous n'en avez pas besoin : Wikipedia, GitHub, docs.python.org, Hacker News et books.toscrape.com ont tous répondu aux requêtes simples dans notre test. Essayez d'abord en simple et n'escaladez que sur un blocage détecté.
Ce dont vous avez besoin avant de commencer
- Un compte QuantumProxies.io avec de la bande passante Web Unlocker. L'unlocker facture à partir d'un solde prépayé en Go, séparé pour le niveau résidentiel et le niveau mobile (sorties opérateur 4G/5G).
- Pour le proxy de transfert : un sous-utilisateur proxy créé sur la page Web Unlocker du tableau de bord. Il ressemble à
unlock-XXXXXXXXavec son propre mot de passe. Ce n'est pas votre clé API. - Pour le point de terminaison REST : une clé API depuis le tableau de bord, envoyée comme
Authorization: Bearer. - Python 3.10 ou plus récent avec
requests, et pour la partie Node.js Node 18 ou plus récent avec le packageundici.
Gardez les deux secrets dans les variables d'environnement. Les exemples lisent QP_UNLOCK_USER, QP_UNLOCK_PASSWORD et QP_API_KEY. Si le mot de passe proxy contient des caractères tels que @ ou :, encodez-le en URL avec urllib.parse.quote avant de le mettre dans une URL de proxy.
Étape 1 : voir le blocage avec des requêtes Python simples
Commencez par l'échec, pour savoir ce que vous réparez. La cible est une recherche d'emploi Indeed. Depuis notre serveur de datacenter à Francfort, elle a répondu 403 avec une page intitulée 'Security Check - Indeed.com'. Via un proxy résidentiel simple, elle a encore répondu 403, cette fois avec un corps demandant au client d'« Activer JavaScript et les cookies pour continuer ». Une IP domestique propre n'était pas suffisante.
import re
import requests

URL = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX"
HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/150.0.0.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}


def title_of(html: str) -> str:
    m = re.search(r"<title[^>]*>(.*?)</title>", html, re.I | re.S)
    return m.group(1).strip() if m else ""


r = requests.get(URL, headers=HEADERS, timeout=30)
print(r.status_code, "|", title_of(r.text))
# Our datacenter run on 29 Sep 2026 saw: 403 | Security Check - Indeed.com
Notre mesure a utilisé curl avec un User-Agent Chrome, pas requests, et il n'y a aucune raison de s'attendre à ce que requests fasse mieux. Une chaîne User-Agent est un en-tête. La couche anti-bot lit également la poignée de main TLS et les paramètres HTTP/2, et ceux-ci disent toujours Python quel que soit le User-Agent que vous définissez. C'est pourquoi échanger les en-têtes vous fait rarement passer la détection de bots dans Python requests ; le côté poignée de main est couvert dans notre guide sur l'empreinte digitale TLS et pourquoi les IPs propres sont encore bloquées. Un 403 signifie que le serveur a compris la requête et l'a refusée (RFC 9110, section 15.5.4). Cela ne signifie pas que votre URL ou vos paramètres sont erronés.
Étape 2 : le même appel via le proxy de transfert
Le proxy de transfert est le plus petit changement au code existant : passez-le comme un proxy et rien d'autre ne bouge. La cible est incluse dans le nom d'utilisateur. -country-us choisit le pays de sortie, -tier-mobile passe aux sorties mobiles, et -profile-firefox (ou chrome, safari, safariios, edge, brave, mobile) fixe une empreinte TLS au lieu de laisser les réessais la faire tourner.
import os
import requests
import urllib3

urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

user = os.environ["QP_UNLOCK_USER"] + "-country-us"   # e.g. unlock-XXXXXXXX-country-us
password = os.environ["QP_UNLOCK_PASSWORD"]
PROXY = f"http://{user}:{password}@unlock.quantumproxies.io:9000"

r = requests.get(
    URL,
    headers=HEADERS,
    proxies={"http": PROXY, "https": PROXY},
    verify=False,   # or verify="qp-unlocker-ca.pem", see below
    timeout=120,
)
print(r.status_code, "|", title_of(r.text))
print("attempts:", r.headers.get("x-qp-unlocker-attempts"),
      "rendered:", r.headers.get("x-qp-unlocker-rendered"))
Le 29 septembre, cela a renvoyé 200 avec la vraie page de résultats, intitulée 'Now Hiring: 2,000 Data Engineer Jobs in Austin, TX | Indeed', à la première tentative TLS, en 2,6 secondes, sans démarrer un navigateur.
Pourquoi verify=False ? Pour réécrire une requête HTTPS, l'unlocker doit terminer le TLS de votre client et présenter son propre certificat pour l'hôte cible. Vous avez deux options propres. Désactivez la vérification pour cette session uniquement, comme ci-dessus, ce que fait curl -k. Ou téléchargez le CA de l'unlocker une fois et faites-lui confiance explicitement, pour que la vérification reste activée :
curl -H "Authorization: Bearer $QP_API_KEY" \
  -o qp-unlocker-ca.pem https://app.quantumproxies.io/api/v1/scraper/unlock/ca
Ensuite, passez verify="qp-unlocker-ca.pem" au lieu de False. Les docs d'utilisation avancée de requests couvrent à la fois l'argument proxies et les ensembles de CA personnalisés. Si vous ne voulez ni l'un ni l'autre, le point de terminaison REST ci-dessous n'a besoin d'aucun certificat.
Étape 3 : le point de terminaison REST, pas de protocole proxy
Le point de terminaison REST exécute le même moteur derrière un appel HTTPS normal. Vous décrivez la requête que vous auriez faite (url, méthode, en-têtes, corps) et obtenez la réponse de l'origine en retour sous forme de JSON. Le seul champ requis est url.
import os
import requests

API_KEY = os.environ["QP_API_KEY"]

resp = requests.post(
    "https://app.quantumproxies.io/api/v1/scraper/unlock",
    headers={"Authorization": f"Bearer {API_KEY}"},
    json={
        "url": URL,
        "country": "us",
        # "tier": "mobile",        # mobile exits, billed on the mobile balance
        # "failOnBlock": True,     # HTTP 502 instead of 200 when every tier was blocked
    },
    timeout=130,
)
resp.raise_for_status()           # 402 = no unlocker GB left, 400 = bad input
data = resp.json()["payload"]

print(data["status"], "blocked:", data["blocked"])
print("attempts:", data["attempts"], "rendered:", data["rendered"],
      "escalated:", data["escalated"], "clearance:", data.get("clearance"))
if data["blocked"]:
    print("block class:", data.get("blockClass"), "vendor:", data.get("vendor"))
html = data.get("body") or ""     # text form; bodyBase64 is always present too
L'enveloppe de réponse est { type, message, payload }. À l'intérieur de payload, vous obtenez status (le code de statut de l'origine), headers, body et bodyBase64, finalUrl, l'empreinte profile, attempts, rendered, escalated, blocked et, lorsque quelque chose a arrêté la requête, blockClass et vendor. Un objet usage rapporte les octets débités pour l'appel.
Un comportement à concevoir : par défaut, une requête qui est restée bloquée après chaque tentative revient quand même de l'API en tant que HTTP 200, avec blocked: true et la page de blocage dans body pour inspection. Elle est étiquetée, non déguisée. Si votre pipeline traite tout 200 comme un succès, définissez failOnBlock: true et vous obtenez un 502 portant les mêmes diagnostics à la place. D'autres champs à connaître : method et body pour les POST, render: "html" pour démarrer dans un navigateur, waitForSelector, et returnCookies.
Voyez comment le Web Unlocker gère les requêtes bloquées
Étape 4 : lire les en-têtes x-qp et gérer un bloc signalé
Via le proxy de transfert, l'unlocker rapporte sur la réponse elle-même. Voici les en-têtes qui valent la peine d'être enregistrés à chaque appel :
| En-tête | Ce qu'il vous dit |
|---|---|
| x-qp-unlocker-attempts | Combien de tentatives la requête a pris, réessais inclus |
| x-qp-unlocker-rendered / x-qp-unlocker-escalated | Réglé à 1 lorsqu'un navigateur sans tête a récupéré la page / lorsque la requête est passée du niveau TLS |
| x-qp-unlocker-profile | Quelle empreinte de navigateur la tentative retournée a utilisée |
| x-qp-clearance | Ce qui s'est passé avec le cache de dédouanement du navigateur lors de cet appel : minted, hit ou miss |
| x-qp-session / x-qp-country | La session de sortie et le pays effectivement utilisés |
| x-qp-unlocker-blocked | Présent uniquement lorsque la page était encore bloquée après chaque tentative |
| x-qp-block-class / x-qp-vendor | Quel type de mur c'était, et quel fournisseur anti-bot, lorsqu'il est reconnu |
Une page qui est encore bloquée n'arrive jamais comme un 200 silencieux. Si l'origine a refusé avec sa propre erreur (403, 429, 503), ce statut est relayé inchangé avec x-qp-unlocker-blocked défini. Si l'origine a servi une page de défi avec un 2xx, le proxy la transforme en 502 et met le code de l'origine dans x-qp-origin-status. Donc une vérification couvre les deux :
class Blocked(Exception):
    pass


s = requests.Session()
s.proxies = {"http": PROXY, "https": PROXY}
s.verify = False  # or "qp-unlocker-ca.pem"

NEXT_STEP = {
    "js_challenge":  "a browser could not clear it; retry later in a pinned session",
    "captcha":       "interactive captcha; decide in your own code",
    "access_denied": "the site denied access; retry with a fresh session or test tier-mobile",
    "rate_limited":  "the site is rate limiting; slow down and retry later",
    "fingerprint":   "the client fingerprint was refused; retry with another profile",
    "geo":           "the content depends on location; set the country explicitly",
    "timeout":       "the target was too slow; raise x-qp-timeout or retry",
}


def unlock_get(url: str, session_id: str | None = None) -> requests.Response:
    headers = {"x-qp-session": session_id} if session_id else {}
    r = s.get(url, headers=headers, timeout=120)
    if "x-qp-unlocker-blocked" in r.headers:
        cls = r.headers.get("x-qp-block-class", "unknown")
        raise Blocked(
            f"{url}: HTTP {r.status_code}, class={cls}, "
            f"vendor={r.headers.get('x-qp-vendor')}, next: {NEXT_STEP.get(cls, 'inspect the body')}"
        )
    return r
Étape 5 : la version Node.js (API web unlocker en JavaScript)
Dans Node, fetch prend un dispatcher. Utilisez ProxyAgent de undici pour le proxy de transfert, et importez fetch du même package pour que les deux versions correspondent. La documentation de ProxyAgent liste les options utilisées ici : token pour la valeur Proxy-Authorization et requestTls pour les paramètres TLS vers la cible.
// unlock.mjs  (npm i undici)
import { readFileSync } from "node:fs";
import { fetch, ProxyAgent } from "undici";

const user = process.env.QP_UNLOCK_USER + "-country-us";
const pass = process.env.QP_UNLOCK_PASSWORD;

const dispatcher = new ProxyAgent({
  uri: "http://unlock.quantumproxies.io:9000",
  token: "Basic " + Buffer.from(user + ":" + pass).toString("base64"),
  requestTls: { rejectUnauthorized: false },
  // verified instead: requestTls: { ca: readFileSync("qp-unlocker-ca.pem") },
});

const url = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX";
const res = await fetch(url, { dispatcher, headers: { "x-qp-session": "indeed-001" } });

if (res.headers.get("x-qp-unlocker-blocked")) {
  console.error("blocked:", res.status, res.headers.get("x-qp-block-class"), res.headers.get("x-qp-vendor"));
} else {
  const html = await res.text();
  console.log(res.status, res.headers.get("x-qp-unlocker-attempts"), html.length);
}
Le point de terminaison REST n'a besoin de rien au-delà du fetch intégré dans Node 18+ :
const resp = await fetch("https://app.quantumproxies.io/api/v1/scraper/unlock", {
  method: "POST",
  headers: {
    Authorization: "Bearer " + process.env.QP_API_KEY,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({ url: "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX", country: "us" }),
});
const { payload } = await resp.json();
console.log(payload.status, payload.blocked, payload.blockClass ?? "-", payload.attempts);
Sur axios, le modèle habituel pour les cibles HTTPS derrière un proxy est de passer un agent de https-proxy-agent en tant que httpsAgent et de définir proxy: false, ou d'appeler le point de terminaison REST ci-dessus et de sauter complètement le protocole proxy.
Étape 6 : quand vous n'avez pas besoin de l'unlocker
L'unlocker est facturé par Go sur chaque octet qu'il déplace, réessais et chargements de pages de navigateur inclus. Lui envoyer des pages qu'une requête simple récupère bien brûle le solde pour rien. Dans notre exécution, ceux-ci sont revenus bien sans aucune aide :
| Site | Simple, serveur de datacenter | Simple, proxy résidentiel | Web Unlocker |
|---|---|---|---|
| docs.python.org (page urllib.request) | 200 | 200 | 200, 1,6 s |
| books.toscrape.com | 200 | 200 | 200, 1,9 s |
| news.ycombinator.com | 200 | 200 | 200, 4,1 s |
| en.wikipedia.org (Web scraping) | 200 | 200 | 200, 1,9 s |
| github.com (dépôt scrapy) | 200 | 200 | 200, 2,0 s |
| bbc.com (Technologie) | 302 redirection | 302 redirection | 200, 1,4 s |
La ligne BBC n'est pas un blocage. Notre client de test n'a pas suivi les redirections, et le 302 est le site vous envoyant vers une autre URL. requests suit les redirections par défaut et atterrit sur la page.
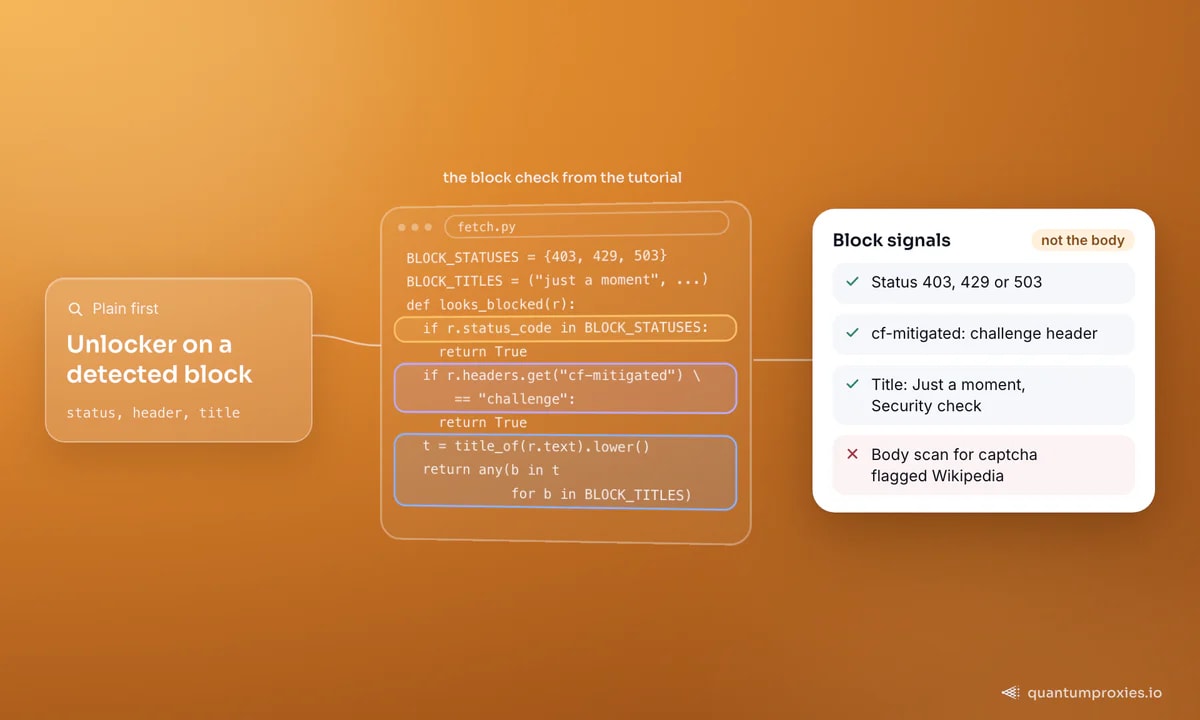
Donc le bon modèle est d'abord en simple, unlocker sur un blocage détecté. La détection nécessite de l'attention. Le scan de marqueur dans notre propre harnais de test a signalé les pages Wikipedia et GitHub comme bloquées car leurs corps contiennent le mot 'captcha', même si les deux ont renvoyé la vraie page avec un 200. Vérifiez le code de statut, l'en-tête cf-mitigated de Cloudflare et le titre de la page, pas tout le corps :
from urllib.parse import urlsplit

BLOCK_STATUSES = {403, 429, 503}
BLOCK_TITLES = (
    "just a moment",                        # Cloudflare challenge
    "attention required",                   # Cloudflare block page
    "access denied",                        # Akamai and others
    "security check",
    "access to this page has been denied",  # PerimeterX
)
needs_unlocker: set[str] = set()            # domains that blocked plain requests


def looks_blocked(r: requests.Response) -> bool:
    if r.status_code in BLOCK_STATUSES:
        return True
    if r.headers.get("cf-mitigated") == "challenge":
        return True
    return any(t in title_of(r.text).lower() for t in BLOCK_TITLES)


def fetch(url: str, session_id: str | None = None) -> tuple[requests.Response, str]:
    host = urlsplit(url).hostname or ""
    if host not in needs_unlocker:
        try:
            r = requests.get(url, headers=HEADERS, timeout=20)
            if not looks_blocked(r):
                return r, "plain"
        except requests.RequestException:
            pass  # a reset or a timeout counts as a block too
        needs_unlocker.add(host)
    return unlock_get(url, session_id), "unlocker"   # from step 4; raises Blocked


for u in ("https://docs.python.org/3/library/urllib.request.html", URL):
    resp, route = fetch(u)
    print(route, resp.status_code, title_of(resp.text)[:60])
La branche except est importante. La catégorie d'ordinateurs portables de Best Buy n'a jamais donné à nos clients simples une réponse HTTP du tout : la connexion a échoué à la fois depuis le serveur de datacenter et le proxy résidentiel. Via l'unlocker, la même URL a renvoyé 200 à la première tentative en 6,3 secondes. Un scraper qui ne vérifie que les codes de statut n'escaladerait jamais celui-là.
Résultats mesurés : quatre sites qui avaient besoin de l'unlocker
Mesuré le 29 septembre 2026. Les requêtes simples étaient curl avec un User-Agent Chrome, une fois depuis un serveur de datacenter à Francfort et une fois via un proxy résidentiel avec une sortie aux États-Unis. Les requêtes Web Unlocker ont utilisé le niveau résidentiel avec une sortie aux États-Unis. Les temps sont en temps réel pour une seule requête.
| Site | Simple, serveur de datacenter | Simple, proxy résidentiel | Web Unlocker |
|---|---|---|---|
| Indeed (recherche d'emploi) | 403, page 'Security Check' | 403, 'Enable JavaScript and cookies to continue' | 200, 1 tentative, 2,6 s |
| Glassdoor (avis sur les entreprises) | 403, page 'Security' avec captcha | 403, 'Enable JavaScript and cookies to continue' | 200, 2 tentatives + navigateur, 17,2 s |
| Walmart (recherche) | 307 redirection, pas de page de résultats | 307 redirection, pas de page de résultats | 200, 1 tentative, 4,8 s |
| Best Buy (catégorie d'ordinateurs portables) | Connexion échouée, pas de réponse | Connexion échouée, pas de réponse | 200, 1 tentative, 6,3 s |
En bref : Indeed, Walmart et Best Buy ont réussi à la première tentative TLS sans navigateur. Glassdoor a eu besoin du chemin complet, deux tentatives TLS puis un navigateur sans tête pour répondre au défi JavaScript, c'est pourquoi cela a pris 17,2 secondes. Pour Walmart, nous n'avons pas enregistré où le 307 pointait. Ce que nous pouvons dire, c'est qu'aucun client simple n'a reçu la page de résultats et que l'unlocker l'a fait.
Les requêtes répétées à un site protégé par défi deviennent plus rapides lorsque vous épinglez une session. Envoyez la même valeur d'en-tête x-qp-session, ou gardez le même -session-<id> dans le nom d'utilisateur du proxy, et le cookie de dédouanement gagné par le navigateur est réutilisé. Dans un test Glassdoor le 29 septembre 2026, avec la session épinglée dans le nom d'utilisateur et deux connexions distinctes, la première requête a pris 14,0 secondes via le navigateur et la seconde 1,4 secondes, avec x-qp-clearance: hit. Notre guide pour scraper les offres d'emploi Indeed couvre ce qu'il faut faire avec la page une fois que vous l'avez.
Si vous êtes arrivé ici à partir d'un 403 qui ne se produit qu'en dehors du navigateur, notre explication sur pourquoi curl obtient un 403 lorsque le navigateur fonctionne approfondit le diagnostic. Pour un aperçu site par site de la couche dont vous avez réellement besoin, voir web unlocker vs proxy résidentiel, testé.
Questions fréquemment posées
Existe-t-il une API de web unlocker gratuite ?
Les pièces open-source sont gratuites : requests, curl_cffi pour un TLS semblable à un navigateur, et Playwright pour un vrai navigateur. Les exécuter correctement est le travail, car vous avez également besoin d'IPs de sortie propres et d'un navigateur pour les défis JavaScript. Sur QuantumProxies.io, créer un compte est gratuit, et le trafic de l'unlocker est facturé par Go à partir d'un solde prépayé que vous rechargez dans le tableau de bord.
Pouvez-vous scraper Glassdoor ou Zillow avec Python ?
Dans notre test du 29 septembre 2026, les requêtes simples vers une page d'avis Glassdoor ont obtenu un 403 à la fois d'un serveur de datacenter et d'un proxy résidentiel, et l'unlocker a renvoyé la page après une escalade de navigateur. Zillow a bloqué le serveur de datacenter mais a servi la page via un proxy résidentiel simple. Vérifiez les conditions de chaque site avant de collecter quoi que ce soit.
Le web scraping peut-il être détecté ?
Oui. Les sites évaluent le type de réseau et l'historique de l'IP, la poignée de main TLS, les paramètres HTTP/2, l'ordre des en-têtes et, sur les pages de défi, ce que JavaScript rapporte sur le navigateur. Une requête Python simple échoue à plusieurs de ces tests à la fois. C'est pourquoi changer uniquement le User-Agent aide rarement, et pourquoi l'unlocker change l'IP, l'empreinte et, si nécessaire, tout le client.
Dois-je installer un certificat pour utiliser le proxy de transfert ?
Seulement pour HTTPS via le proxy de transfert classique, car l'unlocker termine le TLS pour réécrire la requête. Soit vous sautez la vérification pour cette session (verify=False en Python, -k en curl) soit vous téléchargez le CA depuis /api/v1/scraper/unlock/ca avec votre clé API et vous lui faites confiance. Le point de terminaison REST n'a besoin d'aucun certificat.
Comment garder la même IP sur plusieurs requêtes ?
Envoyez la même valeur d'en-tête x-qp-session sur chaque requête via le proxy de transfert, ou mettez le même -session-<id> dans le nom d'utilisateur du proxy. Les appels partageant cette session partent de la même sortie, et un cookie de dédouanement gagné par le navigateur est réutilisé. Sur le point de terminaison REST, passez un sessionId avec la rotation réglée sur sticky. Une session sticky peut durer de 3 à 1 440 minutes.
Le modèle entier tient en une phrase : récupérez simplement, détectez un blocage par statut, en-tête et titre, n'envoyez que ces URL via l'unlocker, et enregistrez les en-têtes x-qp pour savoir combien chaque page vous a coûté. Commencez avec le niveau résidentiel, et gardez le niveau Mobile pour les cibles qui refusent également les plages résidentielles.