Tutorial de la API de Web Unlocker: Python y Node.js, Bloqueado vs Desbloqueado
Código funcional en Python y Node.js para una API de desbloqueo web: la misma solicitud contra un sitio que bloquea clientes simples y uno que no, cómo leer lo que informa el desbloqueador, y un asistente que solo paga por el desbloqueador cuando se detecta un bloqueo.
Una API de desbloqueo web reproduce una solicitud HTTP desde una IP residencial bajo una huella digital TLS de navegador, reintentando con una IP nueva y cambiando a un navegador real cuando el sitio responde con un desafío. Este tutorial de la API de desbloqueo web lo muestra en Python y Node.js, en un sitio que bloquea clientes simples y uno que no.
Cada resultado citado a continuación fue medido el 29 de septiembre de 2026: la misma URL obtenida con curl simple desde un servidor de centro de datos en Frankfurt, con curl simple a través de un proxy residencial con salida en EE.UU., y a través del Web Unlocker de QuantumProxies.io con salida en EE.UU. Donde un sitio no necesitó el desbloqueador, lo decimos, porque la solicitud más barata es la que funciona sin él.
- Dos formas de acceso: un proxy directo en
unlock.quantumproxies.io:9000para código que ya habla el protocolo de proxy, oPOST /api/v1/scraper/unlockcon tu clave API para todo lo demás. - Lo que obtienes de vuelta: el estado, encabezados y cuerpo del origen, más encabezados
x-qp-*que indican cuántos intentos tomó, si se ejecutó un navegador y qué tipo de muro lo detuvo si lo hizo. - Cuando no lo necesitas: Wikipedia, GitHub, docs.python.org, Hacker News y books.toscrape.com respondieron solicitudes simples en nuestra prueba. Intenta primero con simple y escala solo si se detecta un bloqueo.
Lo que necesitas antes de comenzar
- Una cuenta de QuantumProxies.io con ancho de banda de Web Unlocker. El desbloqueador cobra de un saldo de GB prepago, separado para el nivel residencial y el nivel móvil (salidas de operador 4G/5G).
- Para el proxy directo: un subusuario de proxy creado en la página de Web Unlocker del panel de control. Se ve como
unlock-XXXXXXXXcon su propia contraseña. No es tu clave API. - Para el punto final REST: una clave API del panel de control, enviada como
Authorization: Bearer. - Python 3.10 o más reciente con
requests, y para la parte de Node.js Node 18 o más reciente con el paqueteundici.
Guarda ambos secretos en variables de entorno. Los ejemplos leen QP_UNLOCK_USER, QP_UNLOCK_PASSWORD y QP_API_KEY. Si la contraseña del proxy contiene caracteres como @ o :, codifícala en URL con urllib.parse.quote antes de ponerla en una URL de proxy.
Paso 1: ver el bloqueo con solicitudes simples de Python
Comienza con el fallo, para que sepas qué estás arreglando. El objetivo es una búsqueda de empleo en Indeed. Desde nuestro servidor de centro de datos en Frankfurt respondió con 403 con una página titulada 'Security Check - Indeed.com'. A través de un proxy residencial simple aún respondió 403, esta vez con un cuerpo pidiendo al cliente 'Enable JavaScript and cookies to continue'. Una IP doméstica limpia no fue suficiente.
import re
import requests

URL = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX"
HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/150.0.0.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}


def title_of(html: str) -> str:
    m = re.search(r"<title[^>]*>(.*?)</title>", html, re.I | re.S)
    return m.group(1).strip() if m else ""


r = requests.get(URL, headers=HEADERS, timeout=30)
print(r.status_code, "|", title_of(r.text))
# Our datacenter run on 29 Sep 2026 saw: 403 | Security Check - Indeed.com
Nuestra medición usó curl con un User-Agent de Chrome, no requests, y no hay razón para esperar que requests tenga mejor suerte. Una cadena de User-Agent es un encabezado. La capa anti-bot también lee el apretón de manos TLS y las configuraciones HTTP/2, y esas aún dicen Python sin importar qué User-Agent configures. Es por eso que cambiar encabezados rara vez te hace pasar la detección de bots en Python requests; el lado del apretón de manos se cubre en nuestra guía sobre huellas digitales TLS y por qué las IPs limpias aún son bloqueadas. Un 403 significa que el servidor entendió la solicitud y la rechazó (RFC 9110, sección 15.5.4). No significa que tu URL o tus parámetros estén mal.
Paso 2: la misma llamada a través del proxy directo
El proxy directo es el cambio más pequeño al código existente: pásalo como un proxy y nada más se mueve. El objetivo viaja en el nombre de usuario. -country-us elige el país de salida, -tier-mobile cambia a salidas móviles, y -profile-firefox (o chrome, safari, safariios, edge, brave, mobile) fija una huella digital TLS en lugar de dejar que los reintentos la roten.
import os
import requests
import urllib3

urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

user = os.environ["QP_UNLOCK_USER"] + "-country-us"   # e.g. unlock-XXXXXXXX-country-us
password = os.environ["QP_UNLOCK_PASSWORD"]
PROXY = f"http://{user}:{password}@unlock.quantumproxies.io:9000"

r = requests.get(
    URL,
    headers=HEADERS,
    proxies={"http": PROXY, "https": PROXY},
    verify=False,   # or verify="qp-unlocker-ca.pem", see below
    timeout=120,
)
print(r.status_code, "|", title_of(r.text))
print("attempts:", r.headers.get("x-qp-unlocker-attempts"),
      "rendered:", r.headers.get("x-qp-unlocker-rendered"))
El 29 de septiembre esto devolvió 200 con la página de resultados real, titulada 'Now Hiring: 2,000 Data Engineer Jobs in Austin, TX | Indeed', en el primer intento TLS, en 2.6 segundos, sin iniciar un navegador.
¿Por qué verify=False? Para reescribir una solicitud HTTPS, el desbloqueador tiene que terminar el TLS de tu cliente y presentar su propio certificado para el host objetivo. Tienes dos opciones limpias. Apaga la verificación solo para esta sesión, como se muestra arriba, que es lo que hace curl -k. O descarga el CA del desbloqueador una vez y confía en él explícitamente, para que la verificación permanezca activada:
curl -H "Authorization: Bearer $QP_API_KEY" \
  -o qp-unlocker-ca.pem https://app.quantumproxies.io/api/v1/scraper/unlock/ca
Luego pasa verify="qp-unlocker-ca.pem" en lugar de False. Los documentos de uso avanzado de requests cubren tanto el argumento proxies como los paquetes de CA personalizados. Si no quieres ninguno, el punto final REST a continuación no necesita ningún certificado.
Paso 3: el punto final REST, sin protocolo de proxy
El punto final REST ejecuta el mismo motor detrás de una llamada HTTPS normal. Describes la solicitud que habrías hecho (url, método, encabezados, cuerpo) y obtienes la respuesta del origen de vuelta como JSON. El único campo requerido es url.
import os
import requests

API_KEY = os.environ["QP_API_KEY"]

resp = requests.post(
    "https://app.quantumproxies.io/api/v1/scraper/unlock",
    headers={"Authorization": f"Bearer {API_KEY}"},
    json={
        "url": URL,
        "country": "us",
        # "tier": "mobile",        # mobile exits, billed on the mobile balance
        # "failOnBlock": True,     # HTTP 502 instead of 200 when every tier was blocked
    },
    timeout=130,
)
resp.raise_for_status()           # 402 = no unlocker GB left, 400 = bad input
data = resp.json()["payload"]

print(data["status"], "blocked:", data["blocked"])
print("attempts:", data["attempts"], "rendered:", data["rendered"],
      "escalated:", data["escalated"], "clearance:", data.get("clearance"))
if data["blocked"]:
    print("block class:", data.get("blockClass"), "vendor:", data.get("vendor"))
html = data.get("body") or ""     # text form; bodyBase64 is always present too
El sobre de respuesta es { type, message, payload }. Dentro de payload obtienes status (el código de estado del origen), headers, body y bodyBase64, finalUrl, la huella digital profile, attempts, rendered, escalated, blocked y, cuando algo detuvo la solicitud, blockClass y vendor. Un objeto usage informa los bytes debitados por la llamada.
Un comportamiento a tener en cuenta: por defecto, una solicitud que permaneció bloqueada después de cada intento aún regresa de la API como HTTP 200, con blocked: true y la página de bloqueo en body para inspección. Está etiquetada, no disfrazada. Si tu canal de procesamiento trata cualquier 200 como éxito, establece failOnBlock: true y obtendrás un 502 con los mismos diagnósticos en su lugar. Otros campos que vale la pena conocer: method y body para POSTs, render: "html" para comenzar en un navegador, waitForSelector, y returnCookies.
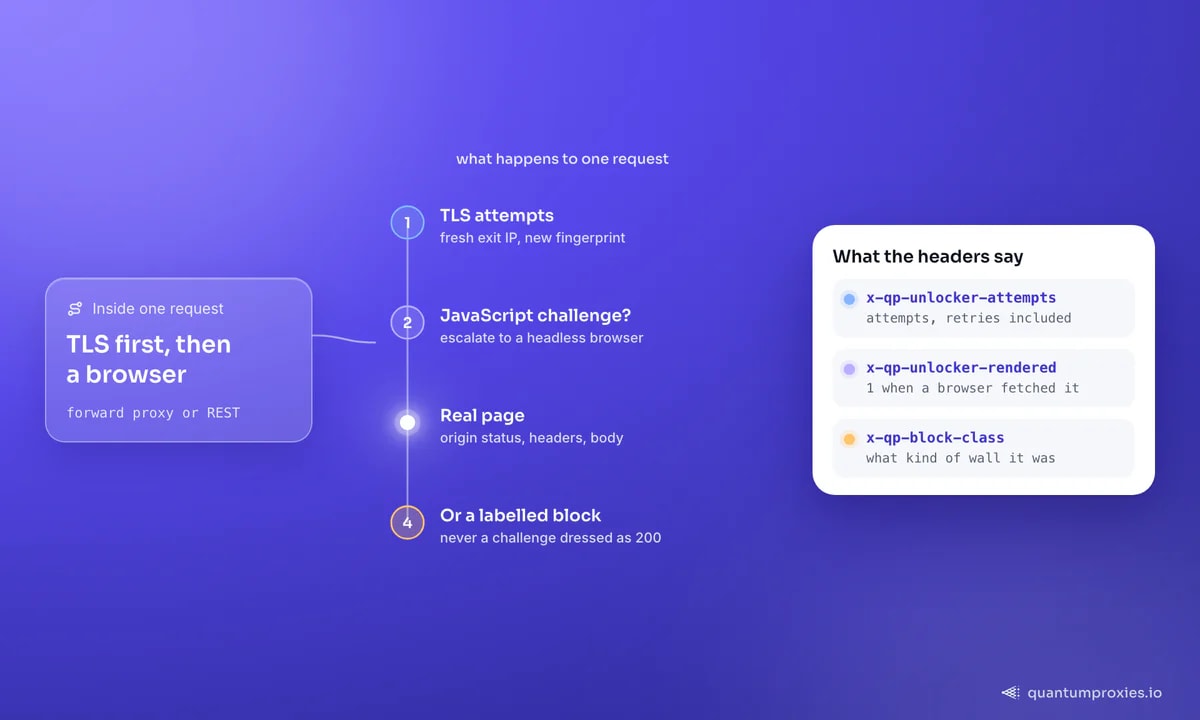
Ve cómo el Web Unlocker maneja solicitudes bloqueadas
Paso 4: lee los encabezados x-qp y maneja un bloqueo reportado
A través del proxy directo, el desbloqueador informa sobre la respuesta en sí. Estos son los encabezados que vale la pena registrar en cada llamada:
| Encabezado | Lo que te dice |
|---|---|
| x-qp-unlocker-attempts | Cuántos intentos tomó la solicitud, incluidos los reintentos |
| x-qp-unlocker-rendered / x-qp-unlocker-escalated | Establecido en 1 cuando un navegador sin cabeza obtuvo la página / cuando la solicitud subió del nivel TLS |
| x-qp-unlocker-profile | Qué huella digital de navegador usó el intento devuelto |
| x-qp-clearance | Qué pasó con la caché de autorización del navegador en esta llamada: minted, hit o miss |
| x-qp-session / x-qp-country | La sesión de salida y el país realmente usados |
| x-qp-unlocker-blocked | Presente solo cuando la página aún estaba bloqueada después de cada intento |
| x-qp-block-class / x-qp-vendor | Qué tipo de muro fue, y qué proveedor anti-bot, cuando se reconoce |
Una página que sigue bloqueada nunca llega como un 200 silencioso. Si el origen rechazó con su propio error (403, 429, 503), ese estado se retransmite sin cambios con x-qp-unlocker-blocked establecido. Si el origen sirvió una página de desafío con un 2xx, el proxy lo convierte en un 502 y pone el código del origen en x-qp-origin-status. Así que una verificación cubre ambos:
class Blocked(Exception):
    pass


s = requests.Session()
s.proxies = {"http": PROXY, "https": PROXY}
s.verify = False  # or "qp-unlocker-ca.pem"

NEXT_STEP = {
    "js_challenge":  "a browser could not clear it; retry later in a pinned session",
    "captcha":       "interactive captcha; decide in your own code",
    "access_denied": "the site denied access; retry with a fresh session or test tier-mobile",
    "rate_limited":  "the site is rate limiting; slow down and retry later",
    "fingerprint":   "the client fingerprint was refused; retry with another profile",
    "geo":           "the content depends on location; set the country explicitly",
    "timeout":       "the target was too slow; raise x-qp-timeout or retry",
}


def unlock_get(url: str, session_id: str | None = None) -> requests.Response:
    headers = {"x-qp-session": session_id} if session_id else {}
    r = s.get(url, headers=headers, timeout=120)
    if "x-qp-unlocker-blocked" in r.headers:
        cls = r.headers.get("x-qp-block-class", "unknown")
        raise Blocked(
            f"{url}: HTTP {r.status_code}, class={cls}, "
            f"vendor={r.headers.get('x-qp-vendor')}, next: {NEXT_STEP.get(cls, 'inspect the body')}"
        )
    return r
Paso 5: la versión de Node.js (API de web unlocker en JavaScript)
En Node, fetch toma un dispatcher. Usa ProxyAgent de undici para el proxy directo, e importa fetch del mismo paquete para que las dos versiones coincidan. La documentación de ProxyAgent enumera las opciones usadas aquí: token para el valor de Proxy-Authorization y requestTls para las configuraciones TLS hacia el objetivo.
// unlock.mjs  (npm i undici)
import { readFileSync } from "node:fs";
import { fetch, ProxyAgent } from "undici";

const user = process.env.QP_UNLOCK_USER + "-country-us";
const pass = process.env.QP_UNLOCK_PASSWORD;

const dispatcher = new ProxyAgent({
  uri: "http://unlock.quantumproxies.io:9000",
  token: "Basic " + Buffer.from(user + ":" + pass).toString("base64"),
  requestTls: { rejectUnauthorized: false },
  // verified instead: requestTls: { ca: readFileSync("qp-unlocker-ca.pem") },
});

const url = "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX";
const res = await fetch(url, { dispatcher, headers: { "x-qp-session": "indeed-001" } });

if (res.headers.get("x-qp-unlocker-blocked")) {
  console.error("blocked:", res.status, res.headers.get("x-qp-block-class"), res.headers.get("x-qp-vendor"));
} else {
  const html = await res.text();
  console.log(res.status, res.headers.get("x-qp-unlocker-attempts"), html.length);
}
El punto final REST no necesita nada más allá del fetch incorporado en Node 18+:
const resp = await fetch("https://app.quantumproxies.io/api/v1/scraper/unlock", {
  method: "POST",
  headers: {
    Authorization: "Bearer " + process.env.QP_API_KEY,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({ url: "https://www.indeed.com/jobs?q=data+engineer&l=Austin%2C+TX", country: "us" }),
});
const { payload } = await resp.json();
console.log(payload.status, payload.blocked, payload.blockClass ?? "-", payload.attempts);
En axios, el patrón habitual para objetivos HTTPS detrás de un proxy es pasar un agente de https-proxy-agent como httpsAgent y establecer proxy: false, o llamar al punto final REST anterior y omitir el protocolo de proxy por completo.
Paso 6: cuando no necesitas el desbloqueador
El desbloqueador se cobra por GB en cada byte que mueve, incluidos reintentos y cargas de página del navegador. Enviarle páginas que una solicitud simple obtiene bien quema saldo por nada. En nuestra ejecución, estos regresaron bien sin ninguna ayuda:
| Sitio | Simple, servidor de centro de datos | Simple, proxy residencial | Web Unlocker |
|---|---|---|---|
| docs.python.org (página urllib.request) | 200 | 200 | 200, 1.6 s |
| books.toscrape.com | 200 | 200 | 200, 1.9 s |
| news.ycombinator.com | 200 | 200 | 200, 4.1 s |
| en.wikipedia.org (Web scraping) | 200 | 200 | 200, 1.9 s |
| github.com (repositorio scrapy) | 200 | 200 | 200, 2.0 s |
| bbc.com (Tecnología) | 302 redirección | 302 redirección | 200, 1.4 s |
La fila de la BBC no es un bloqueo. Nuestro cliente de prueba no siguió redirecciones, y el 302 es el sitio enviándote a otra URL. requests sigue redirecciones por defecto y aterriza en la página.
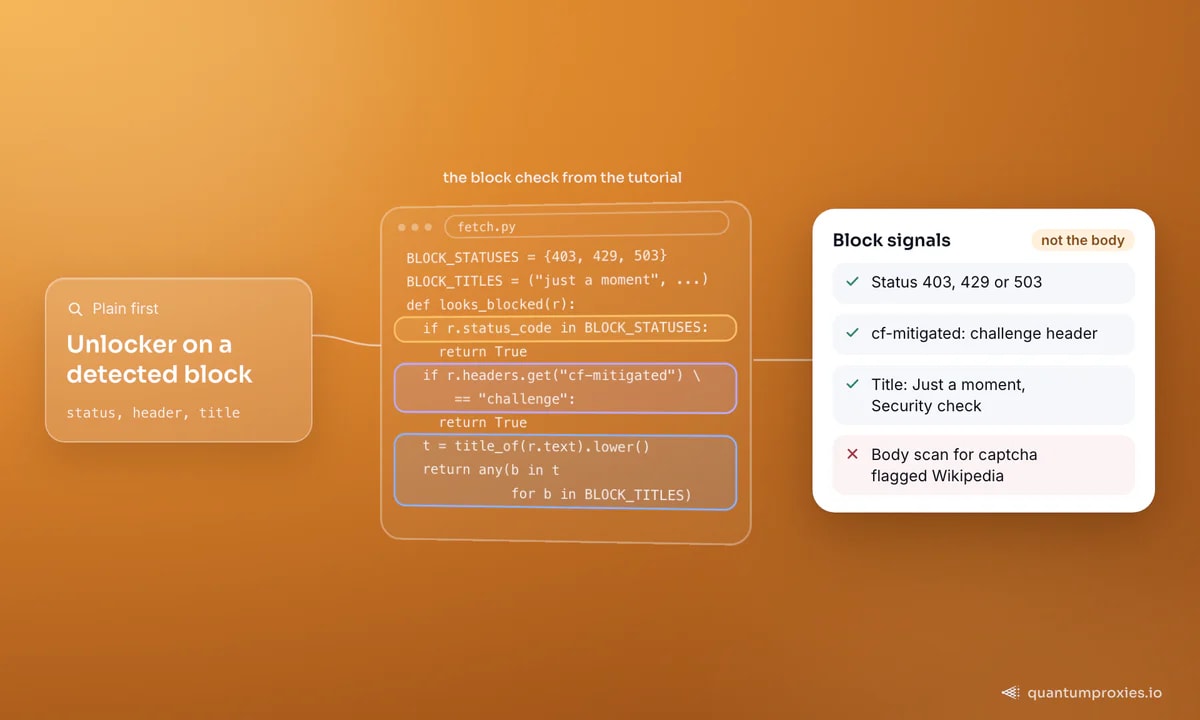
Así que el patrón correcto es simple primero, desbloqueador en un bloqueo detectado. La detección necesita cuidado. El escaneo de marcadores en nuestro propio arnés de prueba marcó las páginas de Wikipedia y GitHub como bloqueadas porque sus cuerpos contienen la palabra 'captcha', aunque ambas devolvieron la página real con un 200. Verifica el código de estado, el encabezado cf-mitigated de Cloudflare y el título de la página, no todo el cuerpo:
from urllib.parse import urlsplit

BLOCK_STATUSES = {403, 429, 503}
BLOCK_TITLES = (
    "just a moment",                        # Cloudflare challenge
    "attention required",                   # Cloudflare block page
    "access denied",                        # Akamai and others
    "security check",
    "access to this page has been denied",  # PerimeterX
)
needs_unlocker: set[str] = set()            # domains that blocked plain requests


def looks_blocked(r: requests.Response) -> bool:
    if r.status_code in BLOCK_STATUSES:
        return True
    if r.headers.get("cf-mitigated") == "challenge":
        return True
    return any(t in title_of(r.text).lower() for t in BLOCK_TITLES)


def fetch(url: str, session_id: str | None = None) -> tuple[requests.Response, str]:
    host = urlsplit(url).hostname or ""
    if host not in needs_unlocker:
        try:
            r = requests.get(url, headers=HEADERS, timeout=20)
            if not looks_blocked(r):
                return r, "plain"
        except requests.RequestException:
            pass  # a reset or a timeout counts as a block too
        needs_unlocker.add(host)
    return unlock_get(url, session_id), "unlocker"   # from step 4; raises Blocked


for u in ("https://docs.python.org/3/library/urllib.request.html", URL):
    resp, route = fetch(u)
    print(route, resp.status_code, title_of(resp.text)[:60])
La rama except importa. La categoría de portátiles de Best Buy nunca dio a nuestros clientes simples una respuesta HTTP en absoluto: la conexión falló tanto desde el servidor de centro de datos como desde el proxy residencial. A través del desbloqueador la misma URL devolvió 200 en el primer intento en 6.3 segundos. Un scraper que solo verifica códigos de estado nunca escalaría ese.
Resultados medidos: cuatro sitios que necesitaron el desbloqueador
Medido el 29 de septiembre de 2026. Las solicitudes simples fueron curl con un User-Agent de Chrome, una vez desde un servidor de centro de datos en Frankfurt y una vez a través de un proxy residencial con salida en EE.UU. Las solicitudes de Web Unlocker usaron el nivel residencial con salida en EE.UU. Los tiempos son de reloj de pared para una sola solicitud.
| Sitio | Simple, servidor de centro de datos | Simple, proxy residencial | Web Unlocker |
|---|---|---|---|
| Indeed (búsqueda de empleo) | 403, página 'Security Check' | 403, 'Enable JavaScript and cookies to continue' | 200, 1 intento, 2.6 s |
| Glassdoor (reseñas de empresas) | 403, página 'Security' con captcha | 403, 'Enable JavaScript and cookies to continue' | 200, 2 intentos + navegador, 17.2 s |
| Walmart (búsqueda) | 307 redirección, sin página de resultados | 307 redirección, sin página de resultados | 200, 1 intento, 4.8 s |
| Best Buy (categoría de portátiles) | Conexión fallida, sin respuesta | Conexión fallida, sin respuesta | 200, 1 intento, 6.3 s |
En resumen: Indeed, Walmart y Best Buy pasaron en el primer intento TLS sin navegador. Glassdoor necesitó el camino completo, dos intentos TLS y luego un navegador sin cabeza para responder al desafío de JavaScript, por lo que tomó 17.2 segundos. Para Walmart no registramos a dónde apuntaba el 307. Lo que podemos decir es que ninguno de los clientes simples recibió la página de resultados y el desbloqueador sí.
Las solicitudes repetidas a un sitio protegido por desafíos se vuelven más rápidas cuando fijas una sesión. Envía el mismo valor de encabezado x-qp-session, o mantén el mismo -session-<id> en el nombre de usuario del proxy, y la cookie de autorización ganada por el navegador se reutiliza. En una prueba de Glassdoor el 29 de septiembre de 2026, con la sesión fijada en el nombre de usuario y dos conexiones separadas, la primera solicitud tomó 14.0 segundos a través del navegador y la segunda 1.4 segundos, con x-qp-clearance: hit. Nuestra guía para scraping de ofertas de trabajo en Indeed cubre qué hacer con la página una vez que la tienes.
Si llegaste aquí desde un 403 que solo ocurre fuera del navegador, nuestro explicador sobre por qué curl obtiene un 403 cuando el navegador funciona profundiza en el diagnóstico. Para una mirada sitio por sitio sobre qué capa realmente necesitas, consulta web unlocker vs proxy residencial, probado.
Preguntas frecuentes
¿Existe una API de desbloqueo web gratuita?
Las piezas de código abierto son gratuitas: requests, curl_cffi para TLS similar a un navegador, y Playwright para un navegador real. Ejecutarlas bien es el trabajo, porque también necesitas IPs de salida limpias y un navegador para desafíos de JavaScript. En QuantumProxies.io, crear una cuenta es gratis, y el tráfico del desbloqueador se cobra por GB desde un saldo prepago que recargas en el panel de control.
¿Puedes hacer scraping de Glassdoor o Zillow con Python?
En nuestra prueba del 29 de septiembre de 2026, las solicitudes simples a una página de reseñas de Glassdoor obtuvieron un 403 tanto de un servidor de centro de datos como de un proxy residencial, y el desbloqueador devolvió la página después de una escalada de navegador. Zillow bloqueó el servidor de centro de datos pero sirvió la página a través de un proxy residencial simple. Verifica los términos de cada sitio antes de recolectar cualquier cosa.
¿Puede detectarse el scraping web?
Sí. Los sitios evalúan el tipo de red y el historial de la IP, el apretón de manos TLS, las configuraciones HTTP/2, el orden de los encabezados y, en las páginas de desafío, lo que JavaScript informa sobre el navegador. Una solicitud simple de Python falla en varios de esos a la vez. Es por eso que cambiar solo el User-Agent rara vez ayuda, y por qué el desbloqueador cambia la IP, la huella digital y, cuando es necesario, todo el cliente.
¿Necesito instalar un certificado para usar el proxy directo?
Solo para HTTPS a través del proxy directo clásico, porque el desbloqueador termina TLS para reescribir la solicitud. O bien omite la verificación para esa sesión (verify=False en Python, -k en curl) o descarga el CA desde /api/v1/scraper/unlock/ca con tu clave API y confía en él. El punto final REST no necesita ningún certificado.
¿Cómo mantengo la misma IP en varias solicitudes?
Envía el mismo valor de encabezado x-qp-session en cada solicitud a través del proxy directo, o pon el mismo -session-<id> en el nombre de usuario del proxy. Las llamadas que comparten esa sesión salen desde la misma salida, y una cookie de autorización ganada por el navegador se reutiliza. En el punto final REST, pasa un sessionId con la rotación configurada como sticky. Una sesión sticky puede durar de 3 a 1,440 minutos.
Todo el patrón cabe en una oración: obtén de manera simple, detecta un bloqueo por estado, encabezado y título, envía solo esas URLs a través del desbloqueador, y registra los encabezados x-qp para que sepas cuánto te costó cada página. Comienza con el nivel residencial, y guarda el nivel Móvil para objetivos que también rechacen rangos residenciales.