Twitch 데이터 스크래핑 방법: 시청자 수, 카테고리 및 스폰서십 신호
공식 Helix API는 가져올 수 있는 데이터를 제한하고 연구자들이 실제로 원하는 데이터를 숨깁니다. Twitch의 자체 GraphQL 엔드포인트에서 시청자 수, 팔로워 총계 및 카테고리 트렌드를 얻는 방법과 이를 유지하는 프록시에 대해 알아보세요.
Twitch는 마케팅 담당자, 분석가 및 스폰서십 스카우트가 모두 원하는 공개 데이터의 금광 위에 앉아 있습니다 — 실시간 시청자 수, 카테고리 순위, 팔로워 총계, 클립, 스트림 제목 및 태그. 문제는 공식 Helix API가 이를 제한된 형태로 제공하며, 사람들이 가장 많이 요청하는 메트릭(예: 게임별 팔로워 수 또는 과거 시청자 트렌드)이 누락되어 있다는 것입니다. 이 가이드는 API가 제공하지 않는 데이터를 스크래핑하는 방법, Twitch의 웹 엔드포인트에서 데이터를 얻는 방법, 그리고 스케줄링된 스크래퍼가 차단되지 않도록 하는 프록시 설정을 다룹니다.
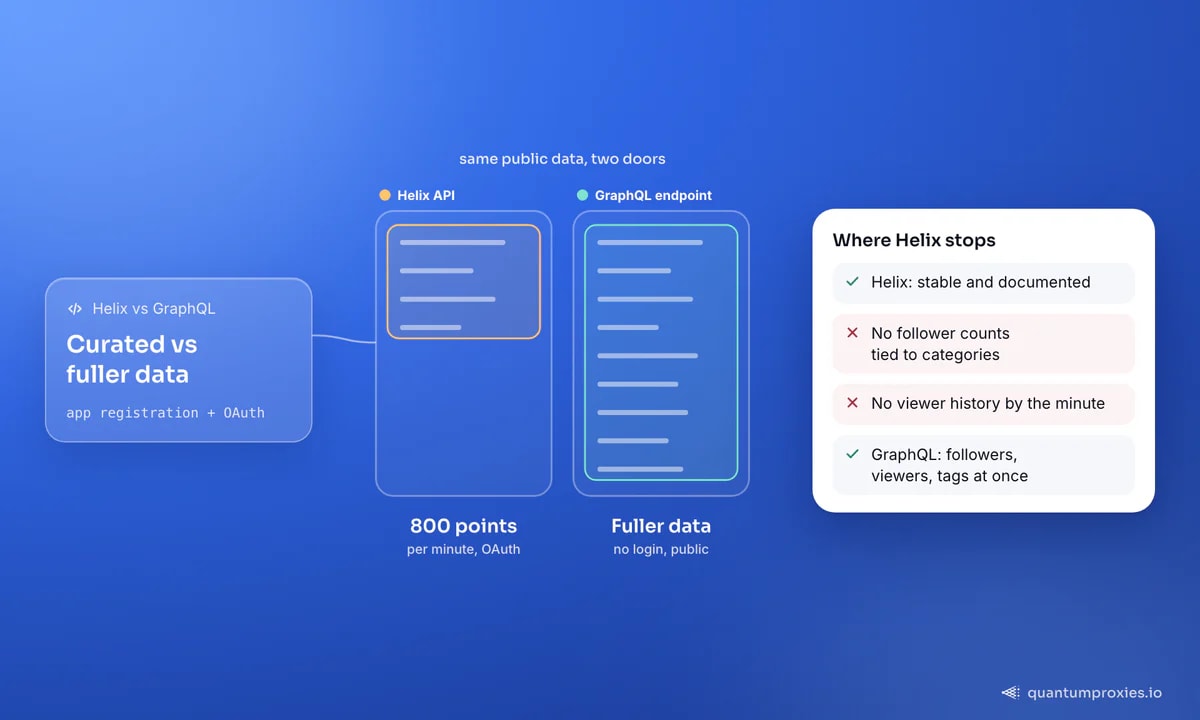
Helix API가 멈추는 지점
Helix는 승인된 경로이며, 그것이 당신을 커버하는 곳에서는 그것을 선호해야 합니다: 안정적이고 문서화되어 있으며 스트림, 사용자, 게임 및 클립에 대한 깨끗한 데이터를 반환합니다. 그러나 그것은 한계가 있습니다. 앱 등록과 OAuth가 필요하고, 포인트 버킷(기본값은 분당 800포인트)으로 당신을 제한하며, 사람들이 원하는 일부 정보를 노출하지 않습니다 — 예를 들어 "이 게임의 상위 채널에 팔로워가 몇 명인지"를 물을 수 없거나 지난 시간 동안의 시청자 수 곡선을 재구성할 수 없습니다. 질문이 그 스키마를 벗어나는 순간, 당신은 스크래핑을 하게 됩니다.
Twitch를 스크래핑한다는 것은 로그인하지 않고 사이트에서 볼 수 있는 동일한 공개 데이터를 코드로 가져오는 것을 의미합니다. 여기에는 개인 데이터나 인증된 페이지가 포함되지 않습니다; 디렉토리, 카테고리 페이지 및 방문자가 볼 수 있는 공개 채널 뷰만을 다룹니다.
빠른 경로: Twitch의 GraphQL 엔드포인트
Twitch의 웹 클라이언트는 사이트의 JavaScript에 포함된 잘 알려진 Client-ID를 사용하여 공개 GraphQL 엔드포인트와 통신합니다. 이를 직접 타격하는 것은 스크래핑의 가장 빠르고 가벼운 방법입니다: 로그인 필요 없음, 헤드리스 브라우저 필요 없음, 구조화된 JSON이 바로 반환됩니다. 공개 Client-ID 헤더와 함께 쿼리를 보내면 스트림, 시청자 수, 태그 및 클립을 한 번의 호출로 얻을 수 있습니다. 웹사이트가 사용하는 것과 동일한 API이기 때문에 방문자가 보는 것과 정확히 동일한 데이터를 반환하며, 페이지 스크래핑보다 훨씬 많은 데이터를 요청당 반환합니다.
import requests

PROXY = "http://USER:PASS@residentialpremium.quantumproxies.io:8080"
proxies = {"http": PROXY, "https": PROXY}

# public web Client-ID shipped in Twitch's own frontend
HEADERS = {"Client-ID": "kimne78kx3ncx6brgo4mv6wki5h1ko", "Content-Type": "application/json"}

query = {
    "query": """
      query($name: String!) {
        user(login: $name) {
          displayName
          followers { totalCount }
          stream { title viewersCount game { name } }
        }
      }""",
    "variables": {"name": "somestreamer"},
}

r = requests.post("https://gql.twitch.tv/gql", json=query,
                  headers=HEADERS, proxies=proxies, timeout=15)
print(r.json()["data"]["user"])
하나의 요청은 표시 이름, 총 팔로워 수, 그리고 채널이 라이브인 경우 스트림 제목, 현재 시청자 수 및 카테고리를 반환합니다. 그 팔로워 총계는 Helix API가 대규모로 얻기 어렵게 만드는 정확한 필드이며, 여기서는 단일 쿼리로 가능합니다.
채널 객체는 기본 정보를 넘어 풍부합니다. 일반적인 기록은 숫자 channelId, login 슬러그 및 displayName, 프로필 설명, 채널이 파트너 상태를 보유하고 있는지 여부, 그리고 라이브 채널의 경우 현재 게임, 시청자 수 및 스트림의 태그를 포함합니다. 태그는 언어, 지역 또는 콘텐츠 유형에 따라 스트리머를 세분화할 때 중요합니다. 로그인 목록에 대해 동일한 쿼리를 실행하면 팔로워 크기, 파트너 상태, 라이브 카테고리를 한 번에 비교할 수 있는 데이터셋을 얻을 수 있습니다.
디렉토리: 카테고리 및 시청자 트렌드
시장 수준의 신호 — 어떤 게임이 인기가 있는지, 하루 동안 시청률이 어떻게 변하는지 — 는 카테고리 디렉토리가 출처입니다. 잘 작동하는 패턴은 일정한 간격으로 카테고리 페이지(예: Just Chatting)를 스냅샷하고, 제목, 스트리머 및 시청자 수와 타임스탬프를 포함한 상위 스트림을 저장하는 것입니다. 이를 15분마다 수행하면 공식 API가 제공하지 않는 시청자 트렌드 곡선과 카테고리 순위를 구축할 수 있습니다. 가벼운 스케줄러와 브라우저 또는 GraphQL 쿼리만 있으면 됩니다; 중요한 것은 간격과 저장, 가져오는 것이 아닙니다.
import requests, time
from datetime import datetime, timezone

def snapshot_category(slug):
    payload = {
        "query": "query($slug: String!){ game(slug:$slug){ streams(first:30){ edges{ node{ title viewersCount broadcaster{ login } } } } } }",
        "variables": {"slug": slug},
    }
    r = requests.post("https://gql.twitch.tv/gql", json=payload,
                      headers=HEADERS, proxies=proxies, timeout=15)
    ts = datetime.now(timezone.utc).isoformat()
    rows = []
    for e in r.json()["data"]["game"]["streams"]["edges"]:
        n = e["node"]
        rows.append({"ts": ts, "login": n["broadcaster"]["login"],
                     "title": n["title"], "viewers": n["viewersCount"]})
    return rows

# run on a schedule (e.g. every 15 min) and append to storage
while True:
    save(snapshot_category("just-chatting"))
    time.sleep(900)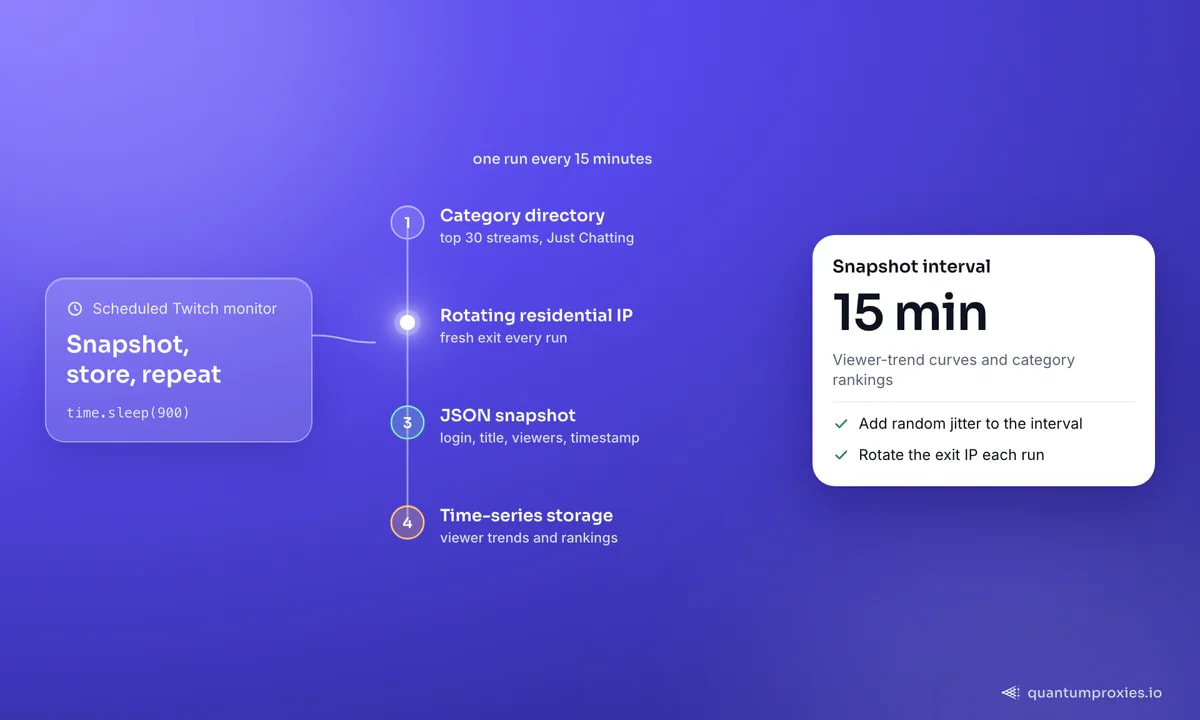
여기서 주거 프록시가 중요한 이유
Twitch는 대형 플랫폼처럼 트래픽을 모니터링합니다. 15분마다 하나의 데이터센터 IP에서 발사되는 스케줄된 스크래퍼는 명백한 패턴이며, GraphQL 엔드포인트는 당신을 플래그하면 오류 또는 빈 결과를 반환하기 시작합니다. 실제 ISP에서 제공하는 주거 IP는 정상적인 시청자 트래픽에 녹아들며, 실행당 회전하여 요청을 분산시켜 단일 주소가 봇처럼 보이지 않도록 합니다. 지역에 민감한 연구 — 일부 카테고리 및 클립은 지역에 따라 다르게 나타납니다 — 를 위해서는 특정 국가 출구도 필요하며, 200개 이상의 국가에 걸친 주거 풀은 이를 제공합니다. 모바일 IP는 가장 공격적인 대상에 대한 가장 강력한 옵션입니다; 우리의 소셜 플랫폼 자동화를 위한 프록시 가이드는 언제 이를 사용할지 다룹니다.
이를 통해 구축할 수 있는 것
사용 사례는 데이터를 따릅니다. 팔로워 수와 카테고리 존재는 인플루언서 발견 및 스폰서십 스카우팅을 지원합니다 — 캠페인 전에 적절한 스트리머를 찾고, 적절한 크기로 조정합니다. 시청자 트렌드 스냅샷은 게임 산업 연구에 기여합니다: 어떤 타이틀이 인기를 얻고 있는지, 언제 관객이 정점을 찍는지, 출시가 시간대별로 어떻게 수행되는지. 클립 및 제목 데이터는 콘텐츠 및 트렌드 분석을 지원합니다. 상업적인 Twitch 스크래퍼는 이 작업에 대해 천 개의 결과당 약 5달러를 청구합니다; 파이프라인을 갖춘 후 자체 프록시로 직접 실행하면 그 비용의 일부만으로 가능하며, 원시 데이터를 소유할 수 있습니다. 동일한 스냅샷 및 차이 접근 방식은 API 할당량을 넘어 YouTube 데이터를 채굴하는 우리의 다른 플랫폼 가이드에도 적용됩니다.
자주 묻는 질문
Twitch에서 데이터를 스크래핑할 수 있나요?
예 — 스트림 제목, 시청자 수, 팔로워 총계, 카테고리 및 클립과 같은 공개 데이터는 로그인 없이 볼 수 있으며 코드로 수집할 수 있습니다. Twitch의 웹 클라이언트는 직접 쿼리할 수 있는 공개 GraphQL 엔드포인트를 사용합니다. 플랫폼의 약관을 존중하고, 개인 또는 인증된 데이터를 피하며, 요청을 조절하세요.
왜 Twitch Helix API를 사용하지 않나요?
Helix가 적합한 곳에서는 사용하세요 — 공식적이고 안정적입니다. 그러나 OAuth가 필요하고, 800포인트-분당 버킷으로 제한하며, 연구자들이 원하는 필드, 예를 들어 카테고리에 연결된 팔로워 수나 분 단위 시청자 기록을 생략합니다. 질문이 그 스키마를 벗어날 때, 공개 웹 엔드포인트를 스크래핑하면 그 간극을 메울 수 있습니다.
Twitch를 스크래핑하려면 프록시가 필요하나요?
한 번의 쿼리에는 필요 없습니다. 스케줄링되거나 대규모로 진행되는 경우에는 필요합니다. 단일 IP에서 반복되는 패턴은 플래그가 붙고 엔드포인트는 오류 또는 빈 데이터를 반환합니다. 회전하는 주거 프록시는 실제 ISP 주소로 요청을 분산시켜 모니터가 완전한 결과를 계속 반환할 수 있게 하며, 지역별 뷰를 가져올 수 있게 합니다.
Twitch 데이터를 얼마나 자주 스냅샷할 수 있나요?
시청자 트렌드의 경우, 10-15분마다가 좋은 균형입니다 — 엔드포인트를 과도하게 사용하지 않고 일일 변화를 볼 수 있을 만큼 자주. 간격에 작은 무작위 지터를 추가하고, 실행마다 종료 IP를 회전시키며, 타임스탬프를 저장하여 트렌드를 재구성할 수 있게 하세요. 더 짧은 간격은 추가 신호 없이 차단 위험을 증가시킵니다.
Twitch의 공개 데이터는 Helix API가 노출하는 것보다 훨씬 풍부하며, 자체 GraphQL 엔드포인트는 팔로워 총계, 시청자 수, 카테고리 디렉토리, 클립을 단일 쿼리로 대부분 반환합니다 — 예의 있는 스케줄에 담아 회전하는 주거 IP를 통해 라우팅하면, 공식 API가 손이 닿지 않는 트렌드 및 스폰서십 신호를 표면화하는 모니터를 가질 수 있습니다.