# 抓取 Shopify products.json:每个商店都公开的端点
忘记解析 HTML 吧。每个 Shopify 商店在 /products.json 提供干净的 JSON——完整的目录、价格、变体、库存。以下是分页限制、加速技巧,以及如何将其转化为竞争对手监控。
任何抓取过电商的人都知道痛苦:脆弱的 CSS 选择器、嵌套的包装 div、布局变化一夜之间破坏一切。Shopify 为你提供了一条出路。几乎每个基于 Shopify 构建的商店都公开一个公共 `/products.json` 端点,返回整个目录的干净、结构化 JSON——标题、句柄、供应商、标签、变体、价格、库存标志和图片。无需解析 HTML,无需无头浏览器。本指南涵盖了端点的工作原理、实际分页限制、一个使抓取大型商店显著加速的技巧,以及如何将其转化为竞争对手价格和库存监控。
## 每个 Shopify 商店的端点
将 `/products.json` 附加到任何 Shopify 商店的根域名,你将获得一个产品的 JSON 列表。这是商店前端使用的数据,设计上为 Ajax API 公开。每个产品都有一个稳定的数字 `id`、一个 `handle`、`vendor`、`product_type`、`tags`、一个 `variants` 数组(每个都有自己的价格、SKU 和 `available` 布尔值),以及图片。这就是你通常需要从产品页面抓取的所有内容,通过一次请求获取。
```python
import requests
url = "https://store.example.com/products.json"
r = requests.get(url, params={"limit": 250, "page": 1}, timeout=15)
products = r.json()["products"]
print(len(products), products[0]["title"])
for v in products[0]["variants"]:
print(v["sku"], v["price"], v["available"])
```
首先有两个注意事项。Shopify 将公共端点限制为**每页 250 个产品**——无论你传递什么参数,这个限制都无法超越,所以忽略设置 `limit=1000000` 并通过一次调用获取所有内容的建议。而且少数商店禁用了该端点(有时自定义构建会关闭它),所以在围绕它构建管道之前,检查是否有有效响应。
## 分页至末尾
由于 250 的限制,完整目录意味着翻页直到遇到空页。简单的循环增加 `page` 并在页面返回空时停止。对于小型商店,这种方法是正确的——一个有几百个产品的商店只需几次请求。
```python
def all_products(base):
page, out = 1, []
while True:
r = requests.get(f"{base}/products.json",
params={"limit": 250, "page": page}, timeout=15)
batch = r.json()["products"]
if not batch:
break
out.extend(batch)
page += 1
return out
```
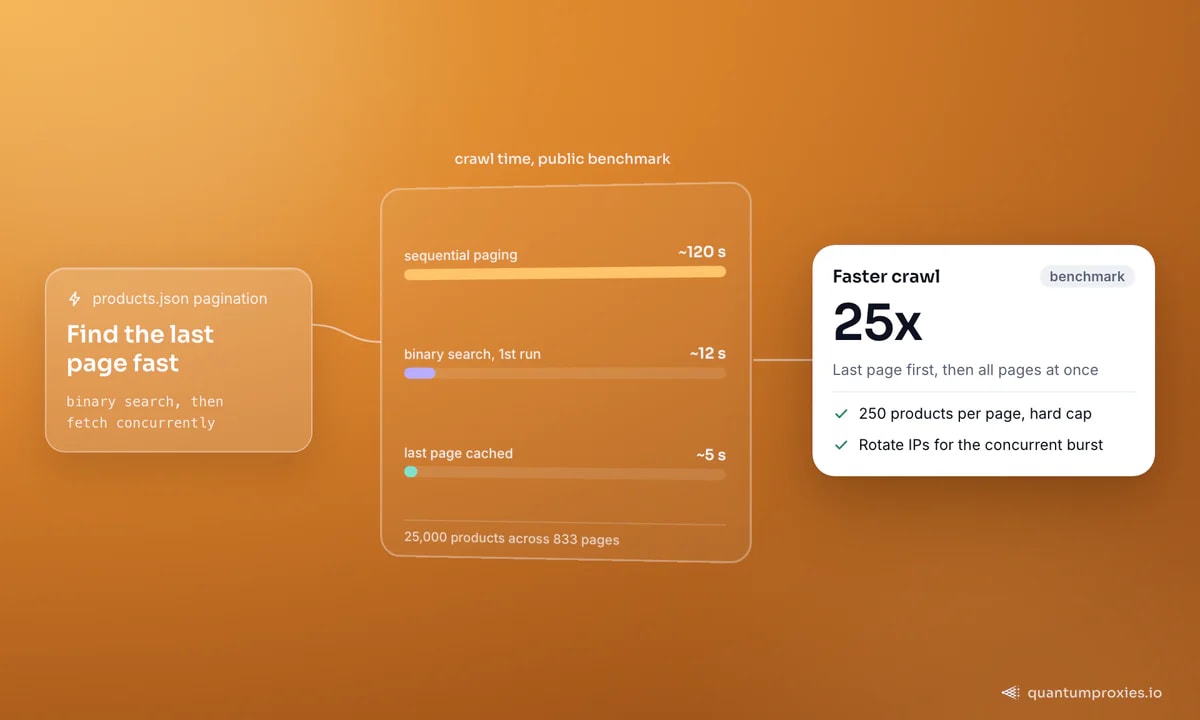
*端点限制为每页 250 个产品——速度来自快速找到最后一页,而不是更大的请求。*
## 25 倍技巧:先找到最后一页
顺序分页在大商店上很慢,因为无法并行化——你不知道何时停止,所以每页都要等待前一页。解决办法是二分搜索:探测页码以找到最后一个非空页,然后同时发出所有页面请求。在一个公共基准测试中,对一个有 25,000 个产品的商店进行测试,跨 833 页,这将抓取时间从大约 120 秒减少到第一次运行的约 12 秒,缓存最后一页号码后约 5 秒——加速 25 倍。通过旋转 IP 路由探测,以免并发请求的爆发触发限流。
```python
PROXY = "http://USER:PASS@residentialpremium.quantumproxies.io:8080"
proxies = {"http": PROXY, "https": PROXY}
def last_page(base, hi=1000):
lo, last = 1, 1
while lo <= hi:
mid = (lo + hi) // 2
r = requests.get(f"{base}/products.json",
params={"limit": 250, "page": mid},
proxies=proxies, timeout=15)
if r.json()["products"]:
last, lo = mid, mid + 1 # go higher
else:
hi = mid - 1 # go lower
return last
# then request pages 1..last_page concurrently
```
正如 Rob Pike 所说,当 n 很小时,复杂的算法很慢——对于一个 200 个产品的商店,跳过二分搜索,只需循环。在数千个目录中,顺序分页会拖慢速度。
## 缩小抓取范围:集合和单个产品
你并不总是需要整个目录。Shopify 在集合级别公开相同的 JSON:`/collections//products.json` 仅返回该集合中的产品,分页方式相同。当你只跟踪一个类别时——运动鞋、香水、单一品牌——而不是整个商店,这是高效的路径。要检查一个产品,将 `.json` 附加到其 URL:`/products/.json` 提供该产品的完整记录,包括每个变体及其库存标志,这对于紧密的补货轮询特定 SKU 而不重新抓取目录非常方便。
结合这两者可以降低请求量和带宽。使用完整端点发现目录一次,存储你关心的句柄,然后按紧凑的时间表轮询单个产品或集合。这个模式是一个可以扩展到数百个商店的监控器与一个悄悄地消耗你的代理预算重新下载未更改目录之间的区别。
## 将其转化为竞争对手监控
真正的价值不是一次性目录导出——而是随时间的差异。按计划快照竞争对手的 `products.json`,按变体 `id` 键控,并比较运行以捕捉价格变化、新产品和补货的瞬间。因为 `available` 和 `price` 存在于每个变体上,你可以在不触及产品页面的情况下获得库存和定价信号。
```python
def snapshot(base):
rows = {}
for p in all_products(base):
for v in p["variants"]:
rows[v["id"]] = {
"product": p["title"],
"sku": v["sku"],
"price": v["price"],
"available": v["available"],
}
return rows
# diff today's snapshot against yesterday's to flag price + stock moves
def changes(old, new):
for vid, cur in new.items():
prev = old.get(vid)
if prev and (prev["price"] != cur["price"] or prev["available"] != cur["available"]):
yield cur["sku"], prev, cur
```
这是[竞争对手价格监控](https://quantumproxies.io/blog/competitor-price-monitoring-with-proxies)和[代发货研究](https://quantumproxies.io/blog/proxies-for-dropshipping-research)的基础——两者都依赖于相同的快照和差异模式,同时跨多个商店进行。
[获取快速数据中心代理用于 Shopify 抓取](https://quantumproxies.io/datacenter-proxies)
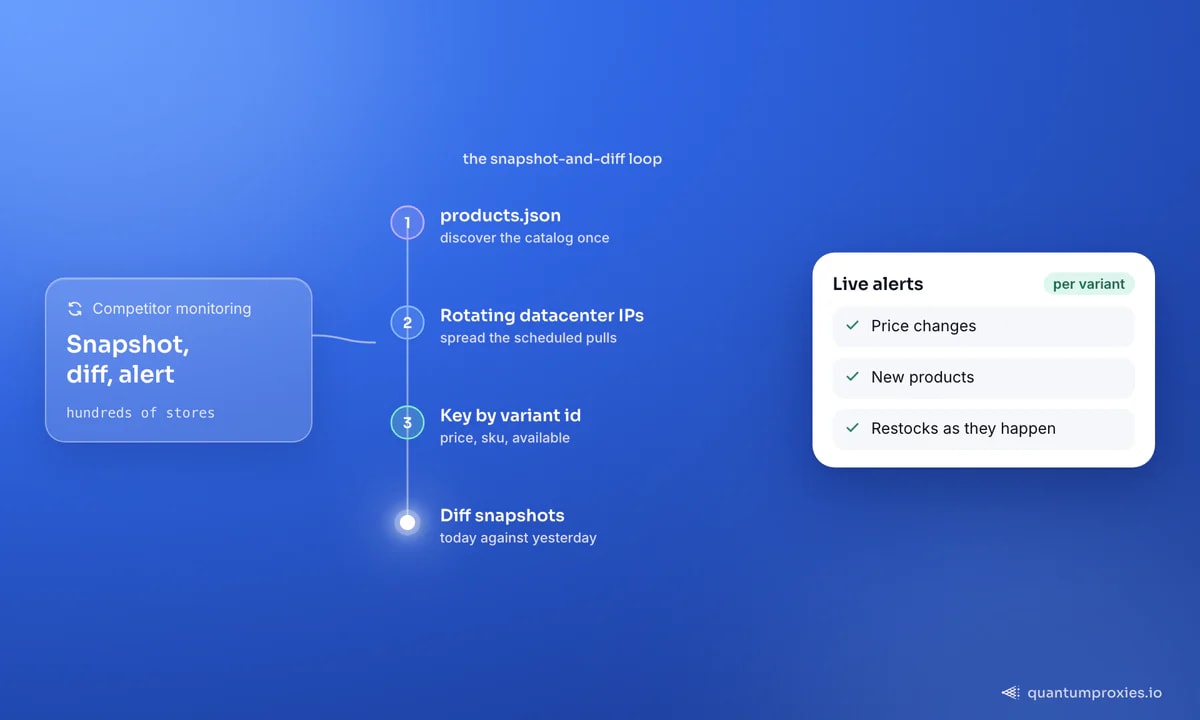
*按计划快照,差异化变体,你就可以在你跟踪的每个商店中获得实时价格和补货警报。*
## 你实际需要哪些代理
`products.json` 端点是公共 JSON,而不是强化的结账流程,所以它是宽容的——但如果抓取数百个商店或按计划猛击一个商店,你将遇到每个 IP 的速率限制。经济的答案是快速的[数据中心代理](https://quantumproxies.io/datacenter-proxies),带有轮换:便宜、快速,并足以将请求分散到多个 IP 上,以免单个 IP 被限流。为那些完全阻止数据中心范围的商店保留住宅 IP。如果一个商店禁用了 `products.json` 并将其目录隐藏在渲染页面或机器人保护后面,[Scraper API](https://quantumproxies.io/scraper-api) 可以为你渲染和轮换,是更清洁的后备方案。我们的[数据中心代理何时胜出指南](https://quantumproxies.io/blog/datacenter-proxies-when-to-use)涵盖了这个决策。
## 常见问题解答
### 如何以 JSON 格式获取 Shopify 商店的所有产品?
在商店的域名上请求 `/products.json`,使用 `?limit=250&page=N` 并递增 `page`,直到页面返回一个空的产品数组。每个响应最多包含 250 个产品及其变体、价格、SKU 和库存标志。对于大型目录,二分搜索最后一页并并发获取页面。
### Shopify products.json 的限制是什么?
公共端点限制为每页 250 个产品——这是 `limit` 接受的最高值。传递更大的数字不会返回更多;你仍然需要分页浏览目录。这是 Shopify 的硬性限制,因此计划分页,而不是尝试通过一次请求获取所有内容。
### 抓取 Shopify products.json 合法吗?
该端点提供无需登录的公开可用产品数据,美国法院通常支持抓取公共数据。尽管如此,仍需遵守商店的服务条款,避免个人数据,并不要过载服务器。这是一般信息,而非法律建议——请根据你的用例和司法管辖区检查具体情况。
### 为什么 products.json 返回 404 或空响应?
要么商店不在 Shopify 上,要么商家在自定义构建中禁用了该端点。有些商店还会限制来自一个 IP 的重复请求,这可能看起来像是错误。确认商店是 Shopify,旋转你的 IP,并在请求之间添加延迟,然后再假设端点消失。
`products.json` 端点将 Shopify 抓取从选择器处理的繁琐工作转变为干净的 JSON 抓取:完整目录、价格和库存在一个 URL 中,每页 250 个,使用二分搜索快速抓取,并轻松转化为竞争对手监控。一次发现,轮询重要的集合和产品,将请求分散到旋转的数据中心 IP 上,你可以按计划跟踪数百个商店,而不会有一次被阻止的运行——无需 HTML 解析器,无需无头浏览器,无需照看脆弱的选择器。
[开始使用 QuantumProxies 抓取 Shopify](https://quantumproxies.io/datacenter-proxies)