# 如何抓取Yelp商业和评论数据进行市场研究
Yelp在去年加强了其反机器人措施,并且其条款明确禁止抓取。以下是数据的结构、住宅地理IP如何访问数据,以及值得了解的合规途径。
Yelp是本地商业情报最丰富的来源之一——涵盖数百万个列表的评分、评论文本、联系方式和类别数据。它也是最难抓取的目标之一。Yelp的条款明确禁止抓取,并且该网站在去年明显加强了反机器人措施,因此以前有效的简单脚本现在遇到了障碍。本指南涵盖了Yelp如何构建其数据、地理匹配的住宅代理如何访问数据、实际限制以及在构建任何东西之前值得了解的合规途径。
## 值得抓取的内容——以及服务条款的现实
有价值的字段是显而易见的:商业名称、地址、电话号码、星级评分、评论数量、类别,以及评论文本本身和评论者情感。汇总到一个大都市,这些数据推动了竞争分析、本地市场规模测算和情感追踪。在开始之前,要清楚规则。Yelp自己的支持页面指出,根据其服务条款第6(b)节,网站不允许抓取、索引或挖掘其内容。这并不意味着技术上无法收集,但这意味着这是一个需要权衡价值与条款的目标,偏好公共非个人数据,并保持适度的量。我们对[2026年网络抓取合法性](https://quantumproxies.io/blog/is-web-scraping-legal-2026)的概述描绘了更广泛的图景——这不是法律建议。
## Yelp如何构建其数据
最有用的一点:您想要的数据很少在可见的HTML中。Yelp通过嵌入在`', r.text, re.S):
try:
data = json.loads(blob)
except ValueError:
continue
# inspect data for businessName, rating, reviewCount, phone
```
评论页面分页时使用一个`start`偏移量,以大约十步递增。这里的实际上限很重要:自动化的Yelp收集往往在每次搜索约240个结果时达到顶峰,因为Yelp限制了其结果分页的深度。围绕这个限制规划您的覆盖范围——按城市、类别和社区分段,而不是试图通过一个广泛的查询无休止地分页:
```python
def yelp_search(term, loc, cap=240):
"""Page a Yelp search via the `start` offset (steps of 10, ~240 ceiling)."""
results = []
for start in range(0, cap, 10):
r = requests.get("https://www.yelp.com/search",
params={"find_desc": term, "find_loc": loc, "start": start},
headers=headers, proxies=proxies, timeout=25)
page = parse_hydration(r.text) # your JSON extractor from above
if not page:
break # empty page = end of results
results.extend(page)
return results
```
两个解析注意事项可以节省时间。Yelp的评论文本和评论者元数据与商业字段一起位于嵌入的负载中,因此一旦找到正确的JSON块,您很少需要每页进行第二次请求。而且由于该网站是一个React应用程序,可见的类名经常变化,而嵌入的数据架构则更加稳定——将您的提取锚定在JSON键上,而不是DOM上,您的抓取器可以在一夜之间打破基于选择器的工具的重设计中生存下来。
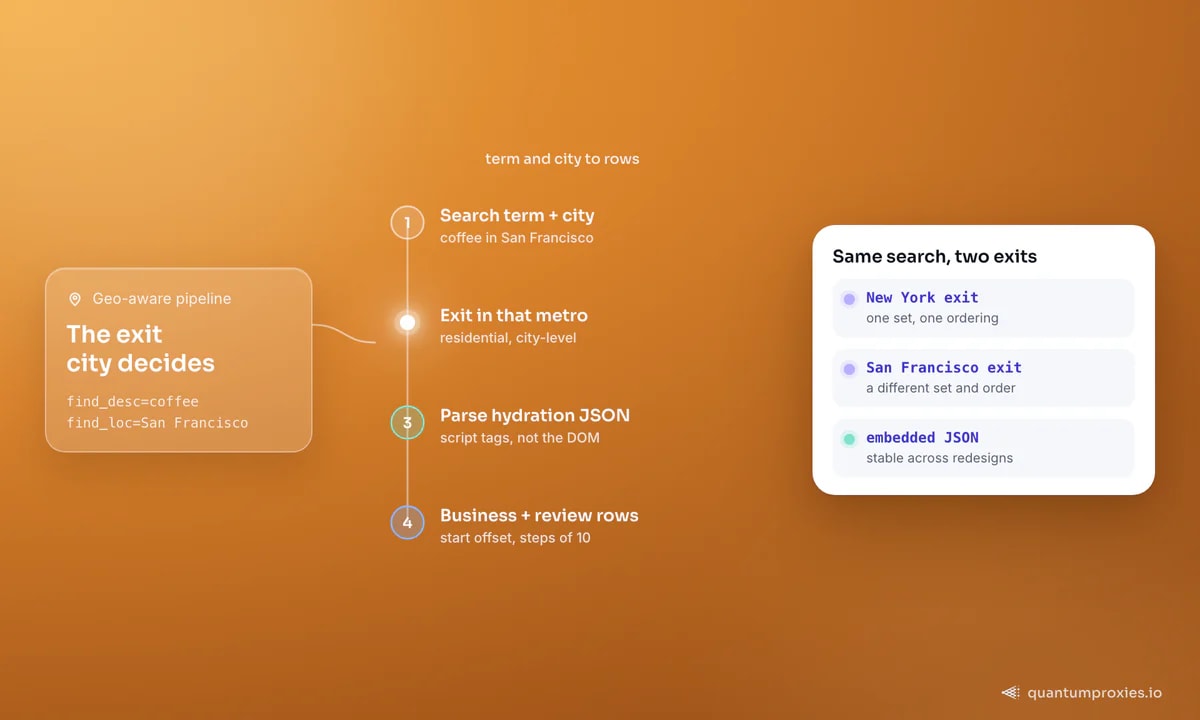
*Yelp结果是位置特定的,因此出口城市决定了您看到的内容。解析嵌入的JSON,而不是渲染的HTML。*
## 地理定位是整个游戏
Yelp是一个本地产品,因此结果在很大程度上取决于请求看起来来自哪里。一个“咖啡”搜索在纽约出口提供的结果与在旧金山出口提供的结果不同。如果您的研究目标是特定的大都市,您的代理需要在该大都市退出——否则会返回偏差数据。一个[住宅代理池](https://quantumproxies.io/residential-proxies),具有跨200多个国家的城市级定位,让您可以将出口固定在您正在分析的市场,这也让您保持在Yelp反机器人层期望的本地流量信任范围内。
地理控制还解锁了Yelp支持的最有价值的分析:比较同一类别在不同大都市之间。运行一个查询——“咖啡”、“水管工”、“健身房”——跨越十个城市,从十个匹配的住宅出口中获取平均评分、评论量和价格等级城市。这个比较数据集是本地市场规模测算的基础,没有单一地点的抓取可以产生它。
[获取地理定位的住宅代理](https://quantumproxies.io/residential-proxies)
## 突破反机器人打击
自从Yelp加强检测以来,三件事情区分了一个完成的运行与一个在挑战中停滞的运行。使用与目标地理匹配的住宅IP,而不是数据中心范围。发送一个完整、一致的浏览器头集——一个真实的Chrome或Safari User-Agent,带有匹配的`Accept`和`Accept-Language`,而不是默认的库字符串。并以抖动保守地节奏,因为来自一个IP的突发是最快的触发器。当Yelp升级到JavaScript挑战或CAPTCHA时,那就是停止手动操作并将页面交给一个[Scraper API](https://quantumproxies.io/scraper-api)的信号,该API渲染JavaScript,携带真实的浏览器指纹并为您轮换IP——通常成功率更高,代码更少。
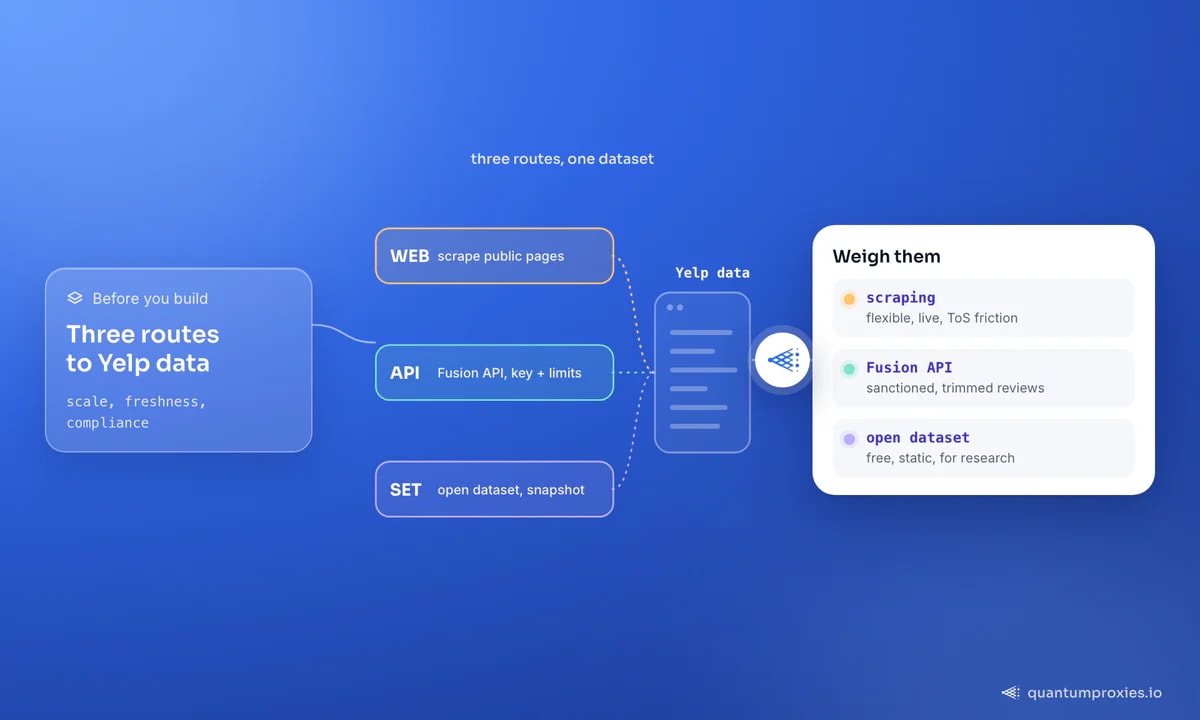
*在构建之前权衡三条途径:灵活的抓取、官方的Fusion API或免费的但静态的开放数据集。*
## 值得了解的合规替代方案
在承诺抓取之前,权衡两个官方途径。Yelp的官方Fusion API在API密钥和速率限制下返回商业详情和精简的评论数据——灵活性较低,但没有服务条款摩擦。而Yelp发布了一个开放数据集,包含数百万条评论、照片和商业属性,供研究使用,遵循其自己的许可;这是一个静态快照,而不是实时数据,但对于模型训练或历史分析,它通常足够。对于跨来源的实时竞争对手和评论监控,相同的技术可以转移到[Google Maps商业数据](https://quantumproxies.io/blog/scrape-google-maps-business-data)、[Trustpilot评论](https://quantumproxies.io/blog/scrape-trustpilot-reviews)和[TripAdvisor](https://quantumproxies.io/blog/scrape-tripadvisor-reviews-data)。
## 常见问题解答
### 抓取Yelp是否合法?
Yelp的服务条款明确禁止抓取、索引和挖掘其内容,因此即使目标是公共页面,收集也违反了网站的声明规则。评论者姓名在GDPR和类似法律下也是个人数据。偏好Fusion API或开放数据集适合的情况,保持适度的量,并在大规模操作时咨询律师。这不是法律建议。
### 每次Yelp搜索可以抓取多少结果?
平均每次搜索大约240个商业,因为Yelp限制了其结果分页的深度。为了全面覆盖市场,按城市、类别和社区分段查询,而不是通过一个广泛的搜索分页——多个狭窄查询胜过一个深度查询。
### 为什么我从不同的服务器获得不同的Yelp结果?
因为Yelp是位置感知的,并根据请求IP的地理位置个性化结果。从不同城市或国家运行的搜索会返回不同的商业和排序。为了准确的本地研究,使用在您分析的确切大都市退出的住宅代理。
### Yelp页面上的数据在哪里?
主要在嵌入的JSON中,而不是可见的HTML中。Yelp通过`