# Jak zeskrobać dane o firmach i recenzjach z Yelp do badań rynkowych
Yelp zaostrzył swoją postawę anty-bot w ostatnim roku, a jego warunki zabraniają skrobania wprost. Oto jak dane są zorganizowane, jak docierają do nich rezydencjalne IP geo i jakie są zgodne ścieżki, które warto znać.
Yelp jest jednym z najbogatszych źródeł informacji o lokalnych firmach - oceny, teksty recenzji, dane kontaktowe i dane kategorii w milionach ofert. Jest również jednym z trudniejszych celów do zeskrobania. Warunki Yelp zabraniają skrobania wprost, a strona zauważalnie zaostrzyła swoją postawę anty-bot w ostatnim roku, więc proste skrypty, które działały wcześniej, teraz napotykają przeszkody. Ten przewodnik obejmuje, jak Yelp strukturuje swoje dane, jak geo-dopasowane rezydencjalne proxy docierają do nich, praktyczne ograniczenia i zgodne ścieżki, które warto znać, zanim cokolwiek zbudujesz.
## Co warto zeskrobać - i rzeczywistość ToS
Wartościowe pola to te oczywiste: nazwa firmy, adres, numer telefonu, ocena gwiazdkowa, liczba recenzji, kategoria i sam tekst recenzji z sentymentem recenzenta. Zebrane w całej metropolii, te dane napędzają analizę konkurencji, lokalne oszacowanie rynku i śledzenie sentymentu. Zanim zaczniesz, bądź świadomy zasad. Własne strony pomocy Yelp stwierdzają, że strona nie zezwala na skrobanie, indeksowanie ani wydobywanie jej treści zgodnie z Sekcją 6(b) jej Warunków Użytkowania. To nie czyni zbierania technicznie niemożliwym, ale oznacza, że jest to cel, gdzie ważysz wartość przeciwko warunkom, preferujesz publiczne dane nieosobowe i utrzymujesz skromny wolumen. Nasz przegląd [legalności skrobania sieci w 2026 roku](https://quantumproxies.io/blog/is-web-scraping-legal-2026) przedstawia szerszy obraz - i żadna z tych informacji nie jest poradą prawną.
## Jak Yelp strukturuje swoje dane
Najbardziej przydatna rzecz do wiedzenia: dane, które chcesz, rzadko są w widocznym HTML. Yelp ładuje swoje strony z JSON osadzonym w tagach `', r.text, re.S):
try:
data = json.loads(blob)
except ValueError:
continue
# inspect data for businessName, rating, reviewCount, phone
```
Strony z recenzjami paginują się z przesunięciem `start`, które zwiększa się w krokach około dziesięciu. Tutaj ma znaczenie praktyczny sufit: zautomatyzowane zbieranie Yelp zazwyczaj kończy się na około 240 wynikach na wyszukiwanie, ponieważ Yelp ogranicza, jak głęboko sięga jego własna paginacja wyników. Zaplanuj swoje pokrycie wokół tego limitu - segmentuj według miasta, kategorii i sąsiedztwa, zamiast próbować przeglądać bez końca jedno szerokie zapytanie:
```python
def yelp_search(term, loc, cap=240):
"""Page a Yelp search via the `start` offset (steps of 10, ~240 ceiling)."""
results = []
for start in range(0, cap, 10):
r = requests.get("https://www.yelp.com/search",
params={"find_desc": term, "find_loc": loc, "start": start},
headers=headers, proxies=proxies, timeout=25)
page = parse_hydration(r.text) # your JSON extractor from above
if not page:
break # empty page = end of results
results.extend(page)
return results
```
Dwie uwagi dotyczące parsowania oszczędzają godziny. Tekst recenzji Yelp i metadane recenzenta znajdują się w osadzonym ładunku obok pól biznesowych, więc gdy już zlokalizujesz odpowiedni blok JSON, rzadko potrzebujesz drugiego żądania na stronę. A ponieważ strona jest aplikacją React, widoczne nazwy klas zmieniają się często, podczas gdy osadzona struktura danych jest znacznie bardziej stabilna - zakotwicz swoje wydobycie do kluczy JSON, a nie DOM, a twój scraper przetrwa przeprojektowania, które łamią narzędzia oparte na selektorach z dnia na dzień.
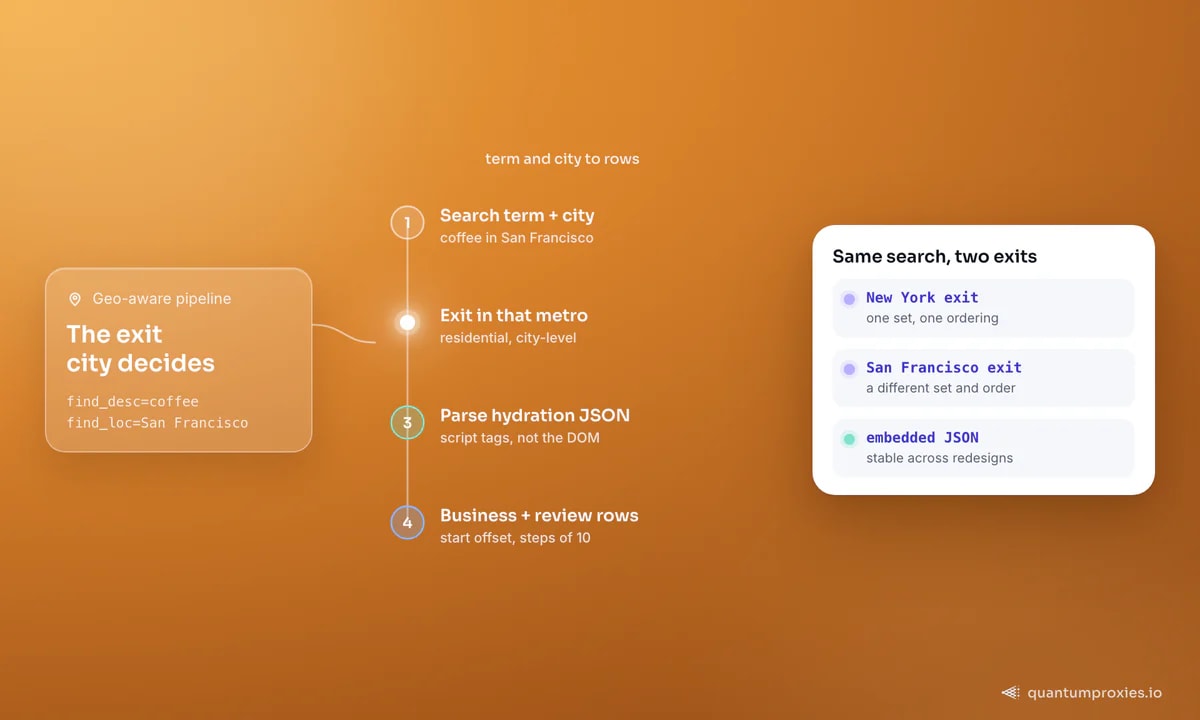
*Wyniki Yelp są specyficzne dla lokalizacji, więc miasto wyjścia decyduje, co widzisz. Parsuj osadzone JSON, a nie renderowany HTML.*
## Geo-targetowanie to cała gra
Yelp jest produktem lokalnym, więc wyniki w dużym stopniu zależą od tego, skąd wydaje się, że pochodzi żądanie. Wyszukiwanie "kawa" obsługiwane dla wyjścia w Nowym Jorku zwraca inne firmy i kolejność niż to samo wyszukiwanie z wyjścia w San Francisco. Jeśli twoje badania celują w konkretną metropolię, twój proxy musi wychodzić w tej metropolii - wszystko inne zwraca zniekształcone dane. [Pula proxy rezydencjalnych](https://quantumproxies.io/residential-proxies) z targetowaniem na poziomie miasta w ponad 200 krajach pozwala przypiąć wyjście do rynku, który analizujesz, co również utrzymuje cię w zakresie zaufania, którego warstwa anty-bot Yelp oczekuje dla lokalnego ruchu.
Kontrola geo również odblokowuje najbardziej wartościową analizę, którą wspiera Yelp: porównywanie tej samej kategorii w różnych metropoliach. Uruchom jedno zapytanie - "kawa", "hydraulicy", "siłownie" - w dziesięciu miastach z dziesięcioma dopasowanymi rezydencjalnymi wyjściami i otrzymujesz średnie oceny, wolumen recenzji i poziom cenowy miasto po mieście. Ten porównawczy zestaw danych jest kręgosłupem lokalnego oszacowania rynku, a żadne skrobanie z jednej lokalizacji nie może go wyprodukować.
[Zdobądź rezydencjalne proxy z geo-targetowaniem](https://quantumproxies.io/residential-proxies)
## Przechodzenie przez represje anty-bot
Od kiedy Yelp zaostrzył wykrywanie, trzy rzeczy oddzielają udane uruchomienie od tego, które zatrzymuje się na wyzwaniach. Używaj rezydencjalnych IP dopasowanych do docelowego geo, a nie zakresów centrów danych. Wysyłaj pełny, spójny zestaw nagłówków przeglądarki - prawdziwy User-Agent Chrome lub Safari z dopasowanymi `Accept` i `Accept-Language`, a nie domyślny ciąg biblioteki. I zachowuj konserwatywne tempo z jitterem, ponieważ wybuchy z jednego IP są najszybszym wyzwalaczem. Kiedy Yelp eskaluje do wyzwań JavaScript lub CAPTCHA, to sygnał, aby przestać ręcznie skrobać i przekazać stronę do [Scraper API](https://quantumproxies.io/scraper-api), które renderuje JavaScript, posiada prawdziwy odcisk przeglądarki i rotuje IP za ciebie - zazwyczaj wyższy wskaźnik sukcesu przy mniejszej ilości kodu.
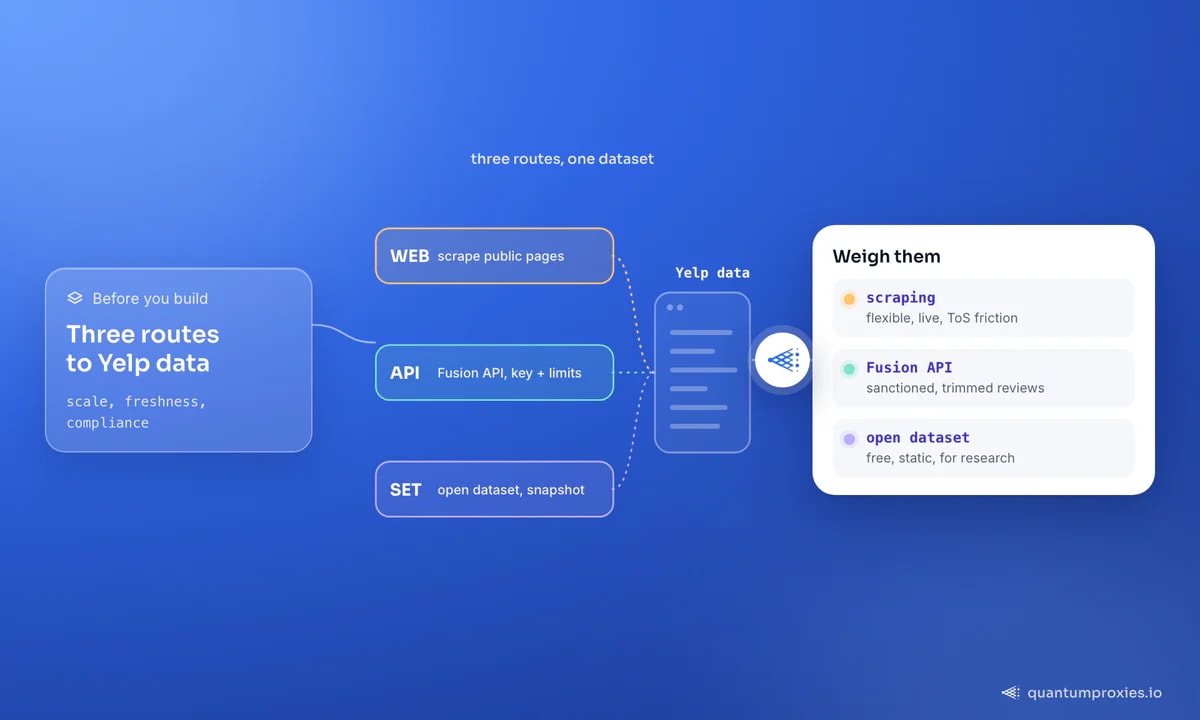
*Rozważ trzy ścieżki, zanim zbudujesz: elastyczne skrobanie, zatwierdzone Fusion API lub darmowy, ale statyczny otwarty zestaw danych.*
## Zgodne alternatywy, które warto znać
Zanim zdecydujesz się na skrobanie, rozważ dwie zatwierdzone ścieżki. Oficjalne Fusion API Yelp zwraca szczegóły biznesowe i przycięty fragment danych recenzji pod kluczem API i limitami szybkości - mniejsza elastyczność, ale brak tarcia z ToS. Yelp publikuje również otwarty zestaw danych milionów recenzji, zdjęć i atrybutów biznesowych do użytku badawczego na podstawie własnej licencji; to statyczny zrzut, a nie dane na żywo, ale do treningu modeli lub analizy historycznej często wystarcza. Do monitorowania konkurencji i recenzji na żywo z różnych źródeł te same techniki można przenieść na [dane biznesowe Google Maps](https://quantumproxies.io/blog/scrape-google-maps-business-data), [recenzje Trustpilot](https://quantumproxies.io/blog/scrape-trustpilot-reviews) i [TripAdvisor](https://quantumproxies.io/blog/scrape-tripadvisor-reviews-data).
## Często zadawane pytania
### Czy skrobanie Yelp jest legalne?
Warunki Usługi Yelp wyraźnie zabraniają skrobania, indeksowania i wydobywania jego treści, więc zbieranie odbywa się wbrew zasadom strony, nawet gdy celuje w publiczne strony. Nazwy recenzentów są również danymi osobowymi zgodnie z RODO i podobnymi przepisami. Preferuj Fusion API lub otwarty zestaw danych, gdzie pasują, utrzymuj skromny wolumen i skonsultuj się z prawnikiem w przypadku działań na dużą skalę. To nie jest porada prawna.
### Ile wyników można zeskrobać na jedno wyszukiwanie Yelp?
Około 240 firm na wyszukiwanie średnio, ponieważ Yelp ogranicza, jak głęboko sięga jego paginacja wyników. Aby w pełni pokryć rynek, segmentuj swoje zapytania według miasta, kategorii i sąsiedztwa, zamiast przeglądać jedno szerokie wyszukiwanie - wiele wąskich zapytań przewyższa jedno głębokie.
### Dlaczego otrzymuję różne wyniki Yelp z różnych serwerów?
Ponieważ Yelp jest świadomy lokalizacji i personalizuje wyniki według geografii żądającego IP. Wyszukiwanie uruchomione z innego miasta lub kraju zwraca inne firmy i kolejność. Do dokładnych badań lokalnych użyj rezydencjalnego proxy, które wychodzi w dokładnej metropolii, którą analizujesz.
### Gdzie są dane na stronie Yelp?
Głównie w osadzonym JSON, a nie w widocznym HTML. Yelp ładuje swoje strony React z JSON wewnątrz tagów `