# 市場調査のためのYelpビジネス&レビュー データのスクレイピング方法
Yelpは昨年、アンチボットの姿勢を強化し、その利用規約ではスクレイピングを完全に禁止しています。ここでは、データの構造、住宅用ジオIPがそれに到達する方法、および知っておくべきコンプライアントなルートについて説明します。
Yelpは、ローカルビジネスのインテリジェンスの最も豊富な情報源の1つであり、数百万のリスティングにわたる評価、レビュー テキスト、連絡先情報、カテゴリーデータを提供しています。しかし、スクレイピングのターゲットとしては最も難しいものの1つでもあります。Yelpの利用規約ではスクレイピングを完全に禁止しており、昨年、アンチボットの姿勢を顕著に強化したため、以前は機能していたカジュアルなスクリプトが今では壁にぶつかります。このガイドでは、Yelpがデータをどのように構造化しているか、ジオマッチされた住宅用プロキシがそれにどのように到達するか、実際の制限、および何かを構築する前に知っておくべきコンプライアントなルートについて説明します。
## スクレイピングする価値があるもの - 利用規約の現実
価値のあるフィールドは明らかなものです:ビジネス名、住所、電話番号、星評価、レビュー数、カテゴリ、そしてレビュアーの感情を含むレビュー テキスト自体です。メトロ全体で集約されたそのデータは、競合分析、ローカル市場のサイズ測定、感情追跡を推進します。始める前に、ルールについて明確にしておくことが重要です。Yelpのサポートページでは、利用規約の第6条(b)に基づき、サイトのコンテンツのスクレイピング、インデックス化、マイニングを許可していないと明記されています。これは技術的に収集が不可能というわけではありませんが、価値を利用規約と比較し、公開された非個人データを優先し、ボリュームを控えめに保つことを意味します。[2026年におけるウェブスクレイピングの合法性](https://quantumproxies.io/blog/is-web-scraping-legal-2026)の概要は、より広い視野を提供しますが、これは法的アドバイスではありません。
## Yelpがデータを構造化する方法
最も有用なことは、欲しいデータは目に見えるHTMLにはほとんどないということです。Yelpはページを`', r.text, re.S):
try:
data = json.loads(blob)
except ValueError:
continue
# inspect data for businessName, rating, reviewCount, phone
```
レビュー ページは約10ステップでインクリメントする`start`オフセットでページネーションされます。ここでは実用的な上限が重要です:自動化されたYelpの収集は、Yelpが独自の結果ページネーションの深さを制限しているため、1検索あたり約240件の結果で上限に達する傾向があります。その制限を考慮してカバレッジを計画し、1つの広範なクエリを無限にページングするのではなく、都市、カテゴリ、近隣ごとにセグメント化してください。
```python
def yelp_search(term, loc, cap=240):
"""Page a Yelp search via the `start` offset (steps of 10, ~240 ceiling)."""
results = []
for start in range(0, cap, 10):
r = requests.get("https://www.yelp.com/search",
params={"find_desc": term, "find_loc": loc, "start": start},
headers=headers, proxies=proxies, timeout=25)
page = parse_hydration(r.text) # your JSON extractor from above
if not page:
break # empty page = end of results
results.extend(page)
return results
```
2つのパースノートが時間を節約します。Yelpのレビュー テキストとレビュアーのメタデータはビジネスフィールドと一緒に埋め込まれたペイロードにあり、適切なJSONブロブを見つけたら、ページごとに2回目のリクエストをする必要はほとんどありません。また、サイトがReactアプリであるため、可視クラス名は頻繁に変更されますが、埋め込まれたデータスキーマははるかに安定しているため、抽出をDOMではなくJSONキーに固定し、セレクタベースのツールを一晩で壊すリデザインに耐えることができます。
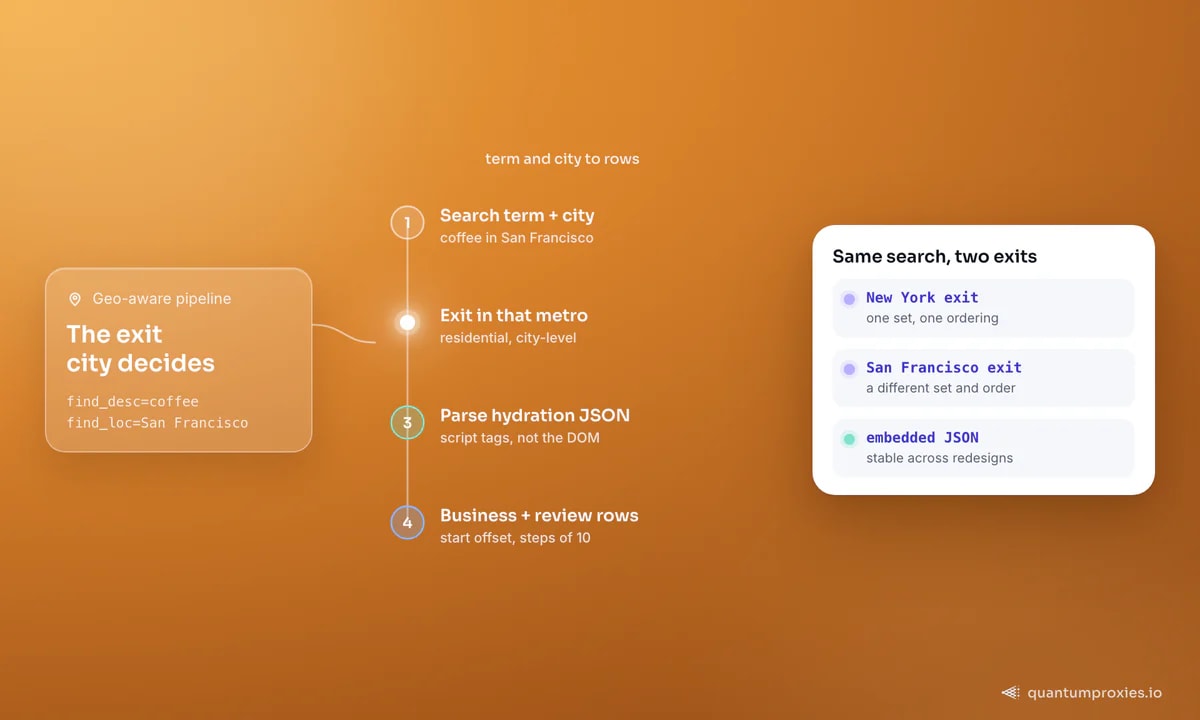
*Yelpの結果は場所に特化しているため、出口都市が表示される内容を決定します。レンダリングされたHTMLではなく、埋め込まれたJSONをパースしてください。*
## ジオターゲティングが全てのゲーム
Yelpはローカル製品であるため、結果はリクエストがどこから来ているように見えるかに大きく依存します。ニューヨークの出口に提供される「コーヒー」検索は、サンフランシスコの出口からの同じ検索とは異なるビジネスと順序を返します。特定のメトロをターゲットにした調査を行う場合、プロキシはそのメトロで終了する必要があります。それ以外は偏ったデータを返します。[200以上の国にわたる都市レベルのターゲティングを備えた住宅用プロキシプール](https://quantumproxies.io/residential-proxies)は、分析している市場に出口を固定することができ、Yelpのアンチボットレイヤーがローカルトラフィックに期待する信頼バンド内に留まることができます。
ジオコントロールは、Yelpがサポートする最も価値のある分析を解放します:メトロ間で同じカテゴリを比較することです。「コーヒー」、「配管工」、「ジム」などの1つのクエリを、10の一致する住宅用出口から10の都市で実行すると、都市ごとの平均評価、レビュー ボリューム、価格帯が得られます。その比較データセットはローカル市場のサイズ測定のバックボーンであり、単一の場所のスクレイピングではそれを生成することはできません。
[ジオターゲティングされた住宅用プロキシを取得する](https://quantumproxies.io/residential-proxies)
## アンチボットの取り締まりを突破する
Yelpが検出を強化して以来、完了するランとチャレンジで停止するランを分ける3つの要素があります。データセンターレンジではなく、ターゲットジオに一致する住宅用IPを使用します。完全で一貫したブラウザヘッダーセットを送信します - 実際のChromeまたはSafariのUser-Agentと一致する`Accept`および`Accept-Language`を使用し、デフォルトのライブラリ文字列ではありません。そして、ジッターを伴って慎重にペースを調整します。1つのIPからのバーストは最も速いトリガーです。YelpがJavaScriptチャレンジやCAPTCHAにエスカレートする場合、それはJavaScriptをレンダリングし、実際のブラウザフィンガープリントを持ち、IPを回転させる[Scraper API](https://quantumproxies.io/scraper-api)にページを渡す合図です - 通常、より少ないコードでより高い成功率を得られます。
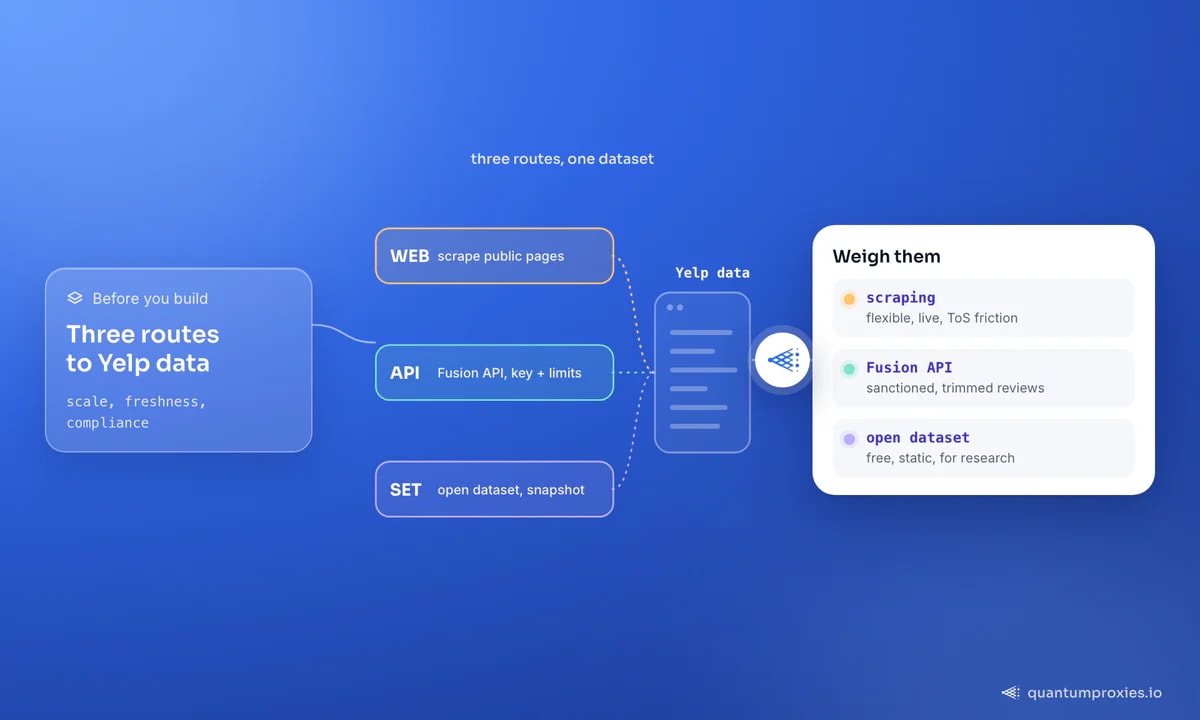
*構築する前に3つのルートを評価してください:柔軟なスクレイピング、承認されたFusion API、または無料だが静的なオープンデータセット。*
## 知っておくべきコンプライアントな代替案
スクレイピングにコミットする前に、2つの承認されたルートを評価してください。Yelpの公式Fusion APIは、APIキーとレート制限の下でビジネスの詳細とトリミングされたレビュー データのスライスを返します - 柔軟性は低いですが、利用規約の摩擦はありません。また、Yelpは、独自のライセンスの下で研究目的で使用するための数百万のレビュー、写真、ビジネス属性のオープンデータセットを公開しています。それはライブデータではなく静的なスナップショットですが、モデルのトレーニングや歴史的な分析にはしばしばそれで十分です。ライブの競合他社とレビューの監視には、同じ技術が[Google Mapsビジネスデータ](https://quantumproxies.io/blog/scrape-google-maps-business-data)、[Trustpilotレビュー](https://quantumproxies.io/blog/scrape-trustpilot-reviews)、および[TripAdvisor](https://quantumproxies.io/blog/scrape-tripadvisor-reviews-data)に転送されます。
## よくある質問
### Yelpをスクレイピングすることは合法ですか?
Yelpの利用規約は、そのコンテンツのスクレイピング、インデックス化、マイニングを明示的に禁止しているため、公開ページをターゲットにしてもサイトの規定に反して収集が行われます。レビュアーの名前もGDPRや類似の法律の下で個人データと見なされます。Fusion APIやオープンデータセットが適合する場合はそれを優先し、ボリュームを控えめに保ち、大規模な場合は弁護士に相談してください。これは法的アドバイスではありません。
### Yelpの検索ごとに何件の結果をスクレイピングできますか?
1検索あたり平均約240件のビジネスです。これは、Yelpが結果のページネーションの深さを制限しているためです。市場を完全にカバーするには、1つの広範な検索をページングするのではなく、都市、カテゴリ、近隣ごとにクエリをセグメント化してください。多くの狭いクエリが1つの深いクエリに勝ります。
### なぜ異なるサーバーから異なるYelpの結果が得られるのですか?
Yelpは位置を認識しており、リクエストIPの地理によって結果をパーソナライズするためです。異なる都市や国から実行された検索は、異なるビジネスと順序を返します。正確なローカル調査を行うには、分析している正確なメトロで終了する住宅用プロキシを使用してください。
### Yelpページのデータはどこにありますか?
主に埋め込まれたJSONにあり、目に見えるHTMLにはありません。YelpはReactページを`